Data Movement и KV-cache: почему AI превращает storage в часть памяти
В предыдущих статьях мы рассмотрели, как AI меняет архитектуру объектного хранения, превращает S3 в платформу данных (см. статью «Apache Iceberg, S3 Tables и S3 Vectors: как обычное объектное хранилище превращается в платформу данных для AI») и влияет на выбор носителей — от NVMe до HDD (см. статью «Где хранить AI-данные: NVMe, SSD, HDD, SMR и объектное хранилище»). Но производительность AI-инфраструктуры зависит не только от того, где хранятся данные, но и от скорости их передачи к GPU.
В этой статье разберем, как S3 over RDMA, GPUDirect Storage и NVIDIA NIXL ускоряют движение данных, почему KV-кэш становится новым объектом хранения и как стираются границы между памятью, сетью и СХД.
Подробный авторский разбор вебинара SNIA «Architecting AI Data Foundations: Object Storage Patterns for Scale, Access, and Longevity» (29 июля 2026 года). Иллюстрации воспроизводят содержание ключевых слайдов SNIA в редакционном оформлении; источник указан под каждой схемой.
Почему передача данных становится узким местом AI-инфраструктуры
Можно построить идеальный уровень NVMe. Можно поставить 400G Ethernet. Можно иметь невероятно быстрые SSD. Но если приложение читает данные через длинный традиционный программный путь, GPU все равно может простаивать.
Классический объектный доступ выглядит примерно так: GPU запрашивает данные → приложение на CPU → HTTP-клиент в пространстве пользователя → ядро → стек TCP/IP → сетевой адаптер → сеть → объектный сервер → обратный путь → буфер CPU → копирование → память GPU.
Каждый слой сам по себе не обязательно медленный. Но вместе появляются переключения контекста, копирования памяти, накладные расходы CPU, обработка протокола, управление буферами, прерывания и переходы в ядро.
Для обычной веб-нагрузки это нормально. Для конвейера GPU, который хочет десятки или сотни GB/s, это становится проблемой.
Accelerated Object I/O: S3 поверх RDMA для высокопроизводительного AI
Поэтому SNIA активно работает над Accelerated Object I/O.
У SNIA есть отдельная техническая рабочая группа Accelerated Object I/O, в задачи которой входят архитектура S3 поверх RDMA, стандартизация высокоскоростного объектного транспорта и оптимизация объектного доступа для AI и других нагрузок с интенсивной работой с данными.
Главная идея очень похожа на то, что уже произошло с блочным и файловым вводом-выводом. Мы хотим сократить участие CPU. Использовать RDMA. Уменьшить количество копирований. Доставлять данные максимально прямо туда, где они потребляются.
В случае AI конечным получателем очень часто является память GPU. Поэтому логический адресат ввода-вывода постепенно меняется: раньше буфер приложения в DRAM CPU, теперь все чаще память ускорителя.
S3 over RDMA: как ускорить объектный доступ без отказа от S3 API
Это не попытка заменить HTTP потому, что HTTP «плохой». HTTP и S3 прекрасны для плоскости управления и традиционного объектного доступа. Проблема появляется, когда через тот же путь нужно непрерывно передавать огромные тензоры или блоки KV.
Поэтому логично разделить плоскость управления и плоскость данных. Плоскость управления все еще может использовать привычную семантику S3: приложение говорит «дай мне объект X». Но массовая передача может идти через RDMA. Семантика остается объектной, а транспорт становится высокопроизводительным.
На мой взгляд, именно это ключевой момент. Если ради скорости мы заставим приложение AI перейти с S3 на проприетарный API хранилища, мы снова получим привязку к вендору. А если семантика S3 сохраняется, но появляется ускоренный путь данных, можно получить одновременно переносимость и производительность.
GPU Direct Storage: как передавать данные из хранилища в память GPU
Самый интересный адресат ввода-вывода для AI уже не CPU. Это GPU.
Поэтому почти все современные высокопроизводительные архитектуры СХД для AI так или иначе приходят к идее «хранилище → сетевой адаптер → память GPU» с минимальным участием CPU. Мы уже видели похожий путь в NVIDIA GPUDirect Storage для файловых и блочных сред. Теперь похожие идеи постепенно приходят в объектное хранилище.
В презентации это сформулировано как перемещение данных в память GPU/CPU без копирования и обход части традиционного пути HTTP/TCP через RoCEv2/RDMA.
И это очень важное изменение. Объектное хранилище исторически оптимизировалось под облачные приложения. Теперь оно начинает оптимизироваться под вычисления, ориентированные на ускорители.
KV-кэш LLM: почему хранение состояния становится частью AI-инфраструктуры
Если первая половина презентации посвящена персистентным данным AI, то ближе к концу появляется тема, которая, на мой взгляд, может породить отдельную категорию продуктов хранения. Это выгрузка KV-кэша.
Чтобы понять ее значение, нужно немного разобрать инференс трансформера. Во время обработки промпта модель рассчитывает для каждого слоя значения Key и Value для механизма внимания. При генерации следующего токена эти значения понадобятся снова. Пересчитывать их для всего предыдущего контекста каждый раз было бы крайне дорого. Поэтому они сохраняются в KV-кэше. При следующем токене модель рассчитывает K/V только для нового токена и использует сохраненные значения предыдущего контекста.
Это и делает авторегрессионный инференс практически реализуемым.
Почему KV-кэш LLM занимает десятки гигабайт
Объем KV приблизительно растет вместе с длиной последовательности, размером батча и числом параллельных запросов, числом слоев, числом KV-голов, размерностью головы и точностью.
Для некоторых моделей класса 70B при очень длинном контексте KV-кэш на одну последовательность может измеряться десятками гигабайт. Современные архитектуры вроде GQA, MLA и скользящего окна внимания уменьшают объем, поэтому универсальной формулы «N байт на токен для любой LLM» не существует.
Но фундаментальная проблема сохраняется. Если у меня тысяча параллельных сессий и длинный контекст, рабочий набор KV легко становится гораздо больше всей доступной HBM.
И тут есть два варианта. Первый: выкинуть старый кэш и потом его пересчитать. Второй: выгрузить его в более дешевую память или хранилище и восстановить при необходимости.
И снова появляется та же экономическая формула: чтение из СХД против пересчета на GPU.
Иерархия памяти AI: HBM, DRAM, NVMe и объектное хранилище
Презентация SNIA предлагает очень понятную иерархию: HBM GPU → DRAM CPU → SSD → объектное хранилище.
Я считаю эту картинку одним из важнейших трендов хранения сейчас, потому что по сути формируется новая иерархия памяти.
Когда-то было: регистры CPU → кэш CPU → DRAM → диск. Теперь для AI мы начинаем видеть: регистры и разделяемая память GPU → HBM GPU → DRAM CPU → локальные NVMe → дезагрегированные NVMe → сетевая высокопроизводительная СХД → объектное хранилище.
Причем для приложения все это потенциально может выглядеть как единое адресное пространство кэша.
NVIDIA Dynamo развивается именно в эту сторону: единый слой памяти и кэша может работать через память GPU, память хоста, удаленную память, доступную по RDMA, SSD и удаленное файловое, объектное или облачное хранилище, используя NIXL как транспортный слой.
Это уже не футурология. Это реальная программная архитектура.
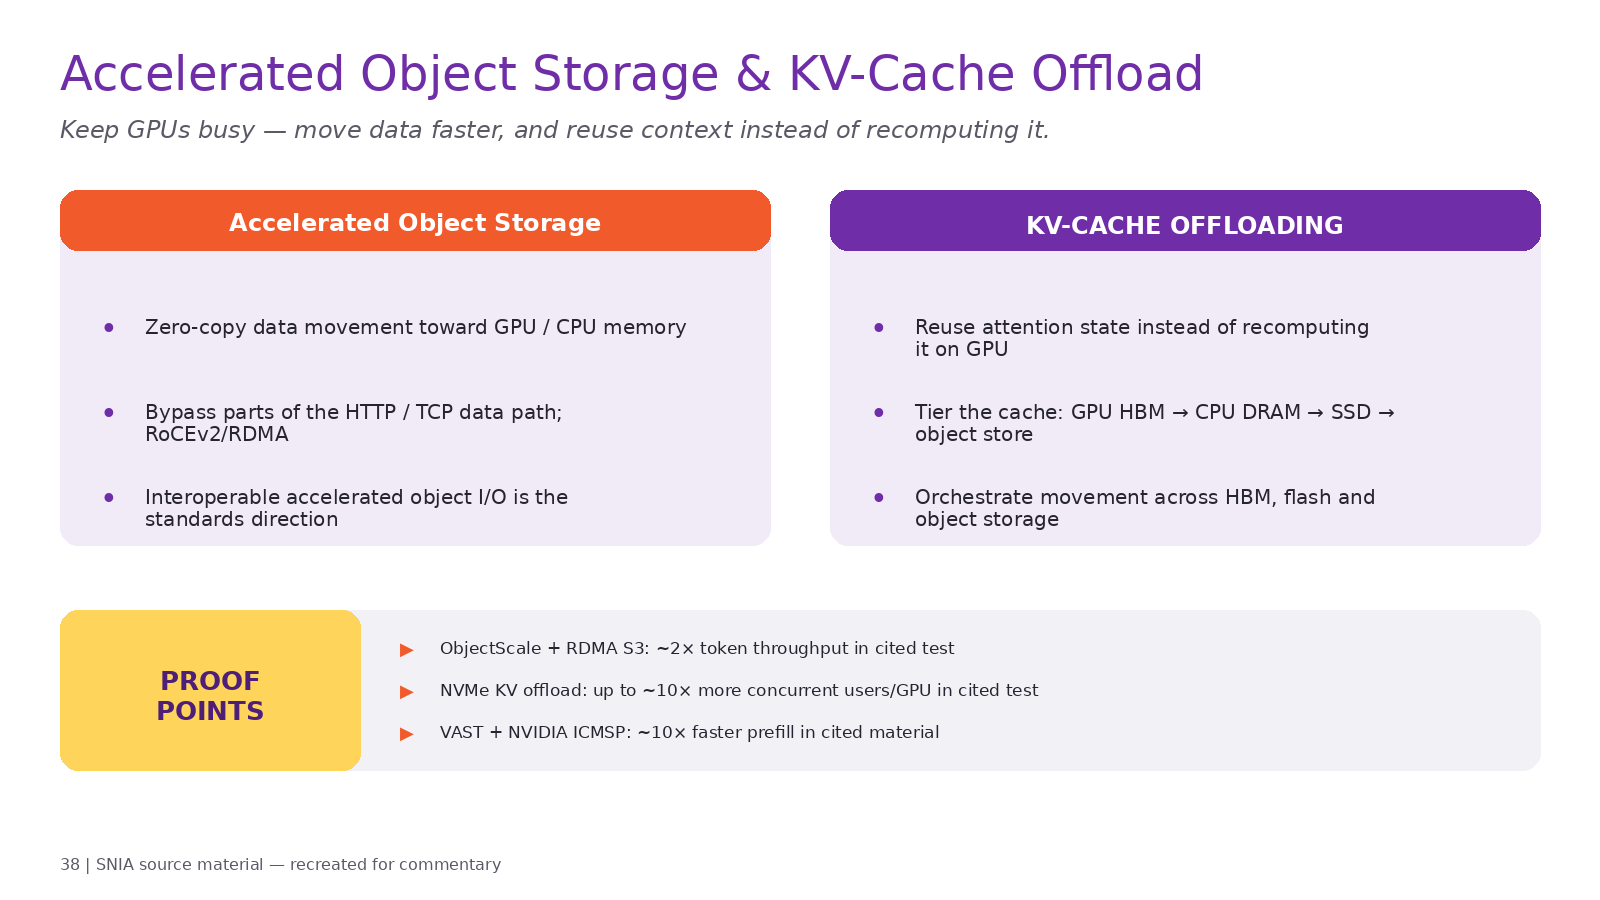
Рисунок 5. Accelerated Object Storage и выгрузка KV-кэша: путь данных RDMA и иерархия HBM → DRAM → SSD → объекты. По материалам SNIA, слайд 38.
KV-кэш: когда хранить состояние дешевле, чем пересчитывать его на GPU
Допустим, пользователь ведет длинный многоходовой диалог. Первые 100 000 токенов контекста уже были обработаны. Пользователь задает следующий короткий вопрос.
Если KV-кэш сохранился, модель может переиспользовать предыдущее состояние prefill. Если кэш потерян, нужно снова прогнать огромный контекст через модель. А это дорогая операция на GPU.
Теперь представим агентный процесс. Агент несколько раз возвращается к одному и тому же системному промпту. Или приложение RAG каждый запрос начинает с большого неизменного префикса корпуса. Или миллионы пользователей используют один и тот же системный промпт.
В этих случаях переиспользование кэша становится колоссальной возможностью для оптимизации. Поэтому KV-кэш можно рассматривать как дедуплицируемый результат вычислений.
Именно поэтому СХД внезапно начинает влиять не только на загрузку данных, но непосредственно на экономику инференса.
Хранение KV-кэша: результаты тестов и влияние на производительность LLM
В презентации SNIA приводится несколько вендорских подтверждений, и к таким цифрам всегда стоит относиться внимательно: результат очень зависит от модели, длины контекста, числа параллельных запросов, доли попаданий в кэш и методологии измерений.
Но направление вполне реальное. Dell, например, публиковал многоходовые тесты с Llama-3.3-70B-Instruct, vLLM, LMCache, NVIDIA NIXL и различными бэкендами хранения. В конкретных тестовых конфигурациях переиспользование KV из хранилища заметно повышало производительность относительно подхода только с HBM при длинной истории и высокой параллельности.
Это вендорский бенчмарк, а не универсальное обещание, но он отлично демонстрирует главный механизм: иногда прочитать состояние KV из СХД дешевле по времени, чем заставить GPU пересчитать prefill.
Вот почему СХД внезапно оказывается на горячем пути инференса.
Каким должно быть хранилище для KV-кэша LLM
Обычное объектное хранилище оптимизируется прежде всего под пропускную способность, емкость, сохранность, доступность и стоимость. Хранилище для KV начинает требовать другого профиля.
Очень важна задержка. Нужно массовое параллельное чтение. Нужен доступ блоками малого и среднего размера. Нужна маршрутизация с учетом локальности. Нужно упреждающее чтение. Нужна политика вытеснения. Нужно быстро определить, существует ли нужный блок KV. Нужна эффективная схема ключей. Нужно учитывать привязку к GPU. Нужно минимальное участие CPU.
То есть хранилище KV-кэша это уже не просто объектная нагрузка. Это действительно может стать отдельным классом СХД.
SNIA уже проводит отдельные сессии про выгрузку KV-кэша в хранилище и про KV-aware системы хранения, рассматривая KV-кэш как объект с постраничной адресацией, доступный через NVMe или RDMA Ethernet.
Я думаю, что в ближайшие годы вокруг этого появится очень много новых продуктов.
Shared KV Cache: зачем LLM-инфраструктуре общее хранилище состояния
Локальный кэш на NVMe относительно простой вариант. Но гораздо интереснее общее хранилище KV.
Почему? Потому что современная архитектура инференса постепенно становится дезагрегированной. Prefill может выполняться на одном наборе GPU, decode на другом. Планировщик может отправить следующий запрос на другой воркер. GPU может выйти из строя. Сессия может мигрировать.
Если KV-кэш находится только локально на конкретной GPU или на NVMe конкретного сервера, планировщик фактически обязан поддерживать привязку сессий. А общий слой KV позволяет отделить состояние от вычислений.
Это очень похоже на то, что когда-то произошло с общей СХД для серверов приложений без состояния. Вычисления становятся одноразовыми. Состояние живет независимо. Для инференса AI это может оказаться чрезвычайно важным архитектурным паттерном.
Data locality в AI: как расположение KV-кэша влияет на планирование GPU
Но здесь появляется новый интересный вопрос.
Если KV-кэш находится в общем хранилище, планировщик должен понимать: где физически находится нужное состояние; какой воркер уже имеет его в HBM; какой воркер имеет часть в DRAM; где ближайшая копия на SSD; какова стоимость передачи; выгоднее загрузить кэш или пересчитать?
То есть метаданные хранилища начинают влиять на планирование GPU. И это еще один пример того, как привычные границы инфраструктурных слоев начинают размываться.
Планировщик должен учитывать хранилище. Хранилище должно учитывать вычисления. Сеть должна учитывать топологию. Среда инференса должна знать, где находится кэш. И это уже настоящее совместное проектирование вычислений, сети и хранения.
NVIDIA NIXL: транспортный слой для KV-кэша и AI-инференса
NIXL, NVIDIA Inference Xfer Library, как раз предназначен для перемещения данных инференса между разнородными областями памяти и хранения. В Dynamo он используется как транспортный слой с низкой задержкой между уровнями.
Это позволяет отделить логическое управление KV от физического способа передачи данных. Сегодня блок может находиться в HBM. Через секунду в DRAM. Потом на SSD. Потом на другом узле. Но среда инференса работает с логической сущностью «блок кэша».
Эта абстракция очень важна. Без нее каждый бэкенд хранения пришлось бы интегрировать непосредственно в каждый движок инференса. Со слоем абстракции появляется возможность строить настоящую экосистему.
Object Storage как последний уровень памяти для AI и LLM
Это довольно необычная мысль. Мы привыкли считать объектное хранилище долговременным персистентным хранилищем. Но в контексте KV-кэша оно начинает выполнять функцию самого емкого и самого медленного уровня иерархии кэша.
HBM максимально быстро и дорого. DRAM быстро. NVMe микросекунды. Сетевой flash выше по задержке. Объекты еще выше. Но объекты могут быть огромными, общими, надежными и экономически дешевыми. То есть для холодного переиспользуемого контекста это вполне разумный кэш последнего уровня.
И тогда граница между иерархией памяти и иерархией хранения практически исчезает.
Data movement в AI: почему важна вся цепочка от накопителя до GPU
Из этого следует еще один вывод презентации: бессмысленно иметь быстрый SSD, если путь до GPU медленный. Поэтому архитектура должна проектироваться сквозным образом.
Носитель. Контроллер. PCIe. Сетевой адаптер. Сетевая фабрика. Протокол. Библиотека в пространстве пользователя. Среда инференса. Память GPU. Планировщик. Только весь конвейер вместе определяет время до первого токена и производительность.
И именно поэтому SNIA связывает в одном докладе настолько разные темы: S3, RDMA, NVMe, KV-кэш, HDD и SMR. С первого взгляда это выглядит как набор несвязанных модных слов. На самом деле они описывают одну сквозную иерархию.
В следующей статье разберем AI Data Pipeline — сквозной конвейер работы с данными для искусственного интеллекта: от загрузки и первичной обработки до подготовки к обучению, использования в инференсе и последующего архивирования.
Источники и дополнительное чтение
- SNIA, страница вебинара: https://www.snia.org/educational-library/architecting-ai-data-foundations-object-storage-patterns-scale-access-and
- SNIA, презентация (43 слайда): https://www.snia.org/sites/default/files/CSI/Architecting-AI-Data-Foundations.pdf
- SNIA Q&A: Architecting AI Data Foundations: https://www.snia.org/blog/2026/architecting-ai-data-foundations-qa
- Документация Apache Iceberg: https://iceberg.apache.org/
- Документация Amazon S3 Tables: https://docs.aws.amazon.com/AmazonS3/latest/userguide/s3-tables.html
- Amazon S3 Vectors: https://aws.amazon.com/s3/features/vectors/
- Microsoft Research: DiskANN / Project Akupara: https://www.microsoft.com/en-us/research/project/project-akupara-approximate-nearest-neighbor-search-for-large-scale-semantic-search/
- Документация NVIDIA Dynamo: https://docs.nvidia.com/dynamo/
Редакционная оговорка. Текст является авторским техническим разбором и интерпретацией материалов SNIA, а не стенограммой. Численные результаты из вендорских материалов следует читать как результаты конкретных тестовых конфигураций, а не как универсальные гарантии производительности.
Автор: Андрей Гантимуров