AI-native object storage: как меняется архитектура хранения данных для ИИ
Содержание:
1. Главное об архитектуре хранения данных для ИИ
2. Почему объектное хранилище становится основой инфраструктуры AI
3. Почему AI увеличивает объем данных: объекты, таблицы, эмбеддинги и индексы AI
4. Персистентные данные AI: объекты, эмбеддинги, модели и KV-кэш
5. Объектное хранилище как единый источник данных для AI
6. Персистентные данные AI: объекты, эмбеддинги, модели и KV-кэш
7. Какие функции нужны AI-native объектному хранилищу
8. Метаданные AI: происхождение, версии и политики жизненного цикла данных
9. Версионирование данных AI: Iceberg, снапшоты и воспроизводимость моделей
10. Почему объектное хранилище становится центром управления данными AI
11. Data lineage для AI: как управлять зависимостями между объектами, эмбеддингами и индексами
12. Политики доступа к данным AI: почему безопасность перемещается в слой хранения
13. Суверенное AI-хранилище: зачем локально хранить модели, эмбеддинги и RAG-данные
14. AI storage: self-managed, cloud и on-premises архитектуры
15. Storage Scanner: зачем AI-native хранилищу фоновый движок обработки данных
16. Compute-to-Data: зачем AI-инфраструктуре вычисления рядом с хранилищем
17. DPU в AI-хранилище: разгрузка CPU и ускорение обработки данных
18. Семантика данных и транспорт: как строится современная AI storage architecture
19. Роль SNIA в развитии стандартов AI storage
20. Главный принцип AI-native storage: семантика данных сверху, оптимальное размещение снизу
21. Что важно учитывать при оценке AI-native storage: ограничения и допущения
22. Куда развивается объектное хранилище в эпоху AI
23. Итог: объектное хранилище становится фундаментом AI Data Platform
24. Что меняется в архитектуре СХД с появлением AI
25. Источники
Главное об архитектуре хранения данных для ИИ
Подробный авторский разбор вебинара SNIA «Architecting AI Data Foundations: Object Storage Patterns for Scale, Access, and Longevity» (29 июля 2026 года). Иллюстрации воспроизводят содержание ключевых слайдов SNIA в редакционном оформлении; источник указан под каждой схемой.
Я разобрал свежий вебинар SNIA «Architecting AI Data Foundations: Object Storage Patterns for Scale, Access, and Longevity», вышедший 29 июля 2026 года. На мой взгляд, его главная мысль гораздо интереснее банального «для AI нужно много места». SNIA фактически предлагает пересмотреть роль объектного хранилища. Оно перестает быть просто дешевым долговременным складом байтов и постепенно превращается в плоскость данных для AI, которая знает не только объекты, но и таблицы, векторы, индексы, метаданные, жизненный цикл, артефакты моделей и, потенциально, даже персистентный KV-кэш. А под единым слоем объектов и API при этом может находиться очень неоднородная инфраструктура: DRAM, NVMe, SSD, HDD и SMR. Именно такое разделение между семантикой данных сверху и экономически оптимальным размещением снизу я считаю главным архитектурным тезисом всей презентации.
Материал ниже не является дословной расшифровкой слайдов. Я специально расширил идеи доклада, объяснил, как работают Iceberg, S3 Tables, S3 Vectors, DiskANN, S3 поверх RDMA и выгрузка KV-кэша, а также добавил свою интерпретацию того, куда все это ведет архитектуру СХД для AI.
Почему объектное хранилище становится основой инфраструктуры AI
Когда я несколько лет назад говорил про объектное хранилище, архитектурная картинка обычно была довольно понятной. Есть файловая или блочная СХД для высокопроизводительного рабочего набора данных, а объектное хранилище представляет собой что-то огромное, относительно дешевое и долговечное. Туда складываются датасеты, резервные копии, архивы, мультимедиа, результаты вычислений, иногда чекпоинты моделей. S3 в такой модели прежде всего API доступа к большим объемам неструктурированных данных.
В презентации SNIA эта граница начинает исчезать.
Доклад Кальяна Гунды из Dell Technologies и Масуда Нури из Seagate, модерируемый Майклом Хоардом, построен вокруг совершенно другой модели: AI создает несколько представлений одних и тех же корпоративных данных, и СХД должна научиться понимать и обслуживать эти представления непосредственно. В повестке авторы отдельно выделяют представления данных AI, Iceberg и S3 Tables, векторы, масштабирование емкости, SMR, Accelerated Object I/O, выгрузку KV-кэша и конвейер данных AI. То есть разговор идет уже не о том, «какой диск лучше для AI», а о полном стеке архитектуры данных.
И здесь я бы сразу сформулировал ключевой сдвиг. Раньше СХД отвечала в основном на вопрос: «Где лежат мои байты и насколько надежно они там лежат?» Новая AI-native архитектура хранения должна отвечать еще как минимум на два вопроса: «Что эти данные собой представляют?» и «Как приложение может их использовать?»
Это принципиальная разница. Один и тот же исходный PDF, лог, набор фотографий, транзакционная история или медицинский датасет может одновременно существовать в нескольких формах. Есть оригинальный объект. Есть очищенная табличная выборка. Есть Parquet-файлы Iceberg. Есть эмбеддинги. Есть ANN-индекс. Есть обучающий датасет. Есть чекпоинт модели. Есть токенизатор и конфигурация. Есть выход модели. Наконец, при инференсе появляется состояние KV.
То есть объем информации растет не только потому, что появляется больше исходных данных. Он растет еще и потому, что AI производит все больше производных представлений данных. И именно это, на мой взгляд, фундаментально меняет СХД.
Почему AI увеличивает объем данных: объекты, таблицы, эмбеддинги и индексы
Один из лучших слайдов презентации называется How Enterprise Data Becomes AI-Ready. Я бы вообще начинал обсуждение современной инфраструктуры AI именно с него.
Сверху находятся корпоративные данные. Они попадают в объектное хранилище, которое выступает в роли источника истины. Но после этого начинается разветвление.
Для аналитики и подготовки данных AI создается курируемый датасет. Он может быть представлен через таблицы Iceberg. Из него начинается обучение, результатом которого становятся артефакты модели.
Параллельно для RAG и семантического поиска исходные данные проходят через модель эмбеддингов. Возникают эмбеддинги, затем векторный индекс, а уже поверх них идет путь выполнения: токены → LLM → ответ.
На слайде очень правильно подчеркнуто, что не каждый датасет проходит через каждый из этих путей. Но практически все персистентные представления в той или иной форме оказываются связаны с СХД.
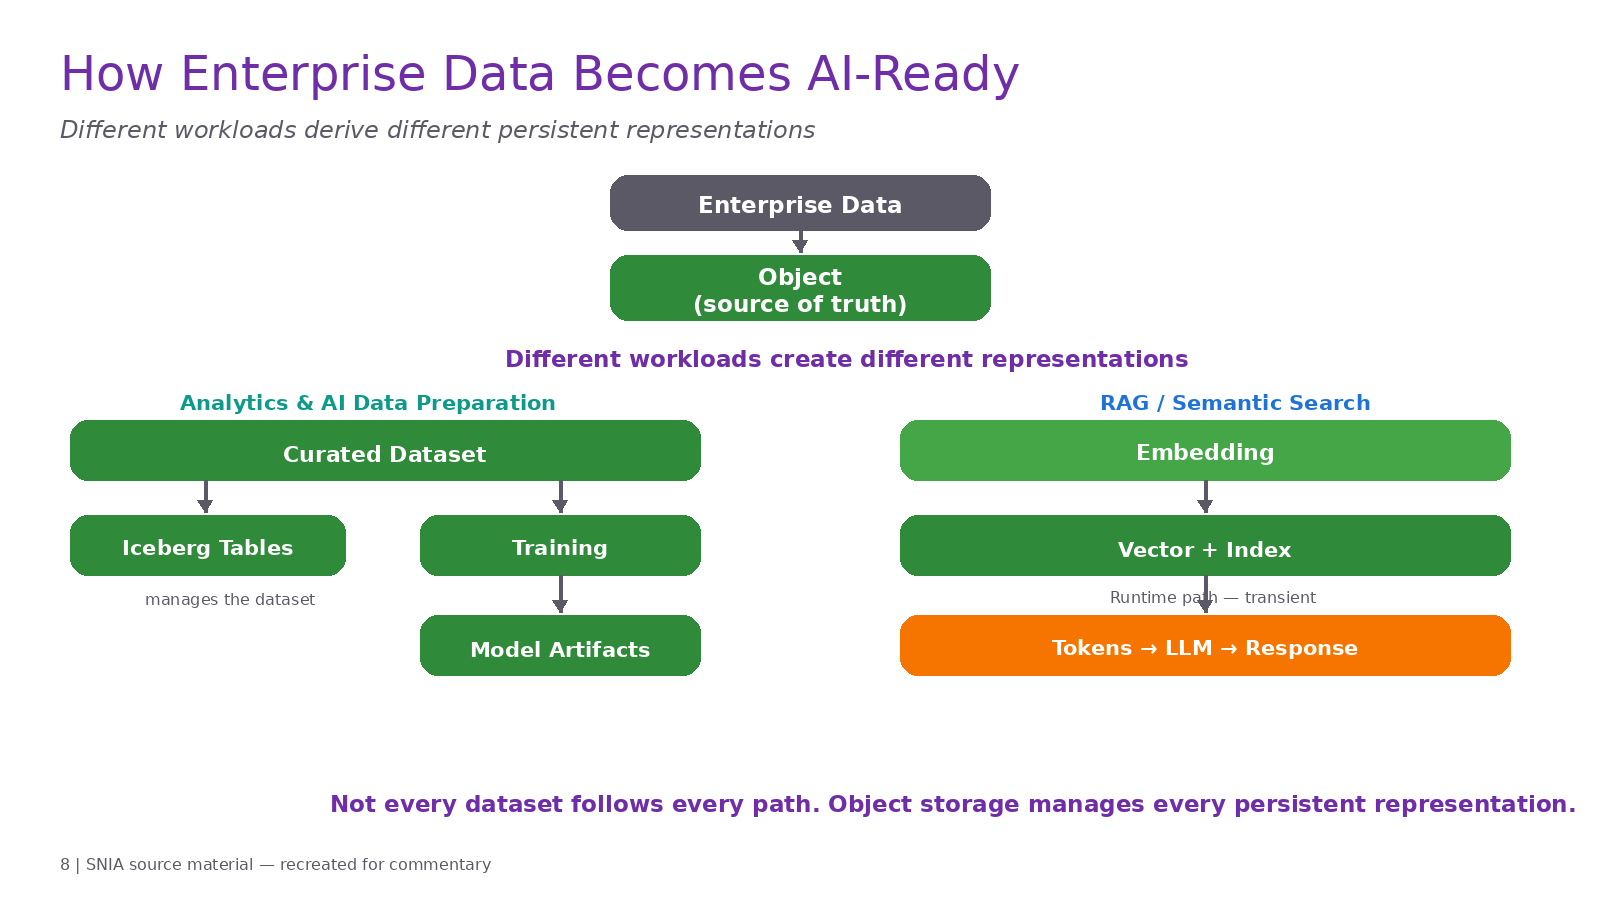
Рисунок 1. Как корпоративные данные превращаются в AI-ready представления: объект как источник истины, Iceberg для курируемых датасетов, эмбеддинги и векторный индекс для RAG. По материалам SNIA, слайд 8
Я бы развил эту идею чуть дальше. Представим корпоративную базу документов. Сам документ может быть DOCX, PDF, HTML или изображением. Это объект. Затем документ разбивается на чанки, и это уже новое представление. Для каждого чанка рассчитывается эмбеддинг, еще одно представление. Эмбеддинги организуются в ANN-индекс, возникает еще одна физическая структура данных. Часть метаданных (автор, гриф безопасности, бизнес-подразделение, дата, язык, класс хранения) может быть вынесена в таблицу.
При RAG система сначала ищет релевантные векторы, затем восстанавливает исходные чанки и передает их в промпт модели. Если запросы повторяются, можно сохранять состояние префикса или KV. Если модель дообучается на этих документах, появляются обучающий датасет, чекпоинты, состояние оптимизатора, веса модели и результаты оценки.
Поэтому старый подход «объем исходного датасета 100 TB, значит примерно 100 TB емкости нам и понадобится» для AI перестает работать.
Сам SNIA в опубликованном после вебинара Q&A приводит довольно впечатляющее замечание: в некоторых сценариях персистентный объем векторной БД может оказаться в 7–10 раз больше исходных сырых данных, поскольку хранятся эмбеддинги, чанки и сопутствующие структуры. Это не универсальный коэффициент, но он хорошо показывает направление проблемы.
Персистентные данные AI: объекты, эмбеддинги, модели и KV-кэш
Мне очень нравится разделение презентации на персистентные и рантайм-данные.
К персистентным авторы относят объект, таблицу, эмбеддинг или векторное представление и артефакты модели. К рантайму относятся токены и KV-кэш. При этом сразу оговаривается важная вещь: KV-кэш традиционно временный, но его можно сделать персистентным.
На первый взгляд это кажется незначительной оговоркой. На самом деле именно в ней спрятан один из самых серьезных сдвигов в хранении данных на ближайшие годы.
Для обычного приложения состояние либо хранится, либо вычисляется. Для LLM возникает третья категория: состояние, которое вычислять дорого, но хранить долго необязательно.
KV-кэш идеальный пример. Его можно пересчитать, поэтому это не источник истины. Но его пересчет требует времени GPU, а время GPU может стоить значительно дороже, чем несколько гигабайт на SSD или в объектном хранилище.
Следовательно, возникает простой экономический вопрос: что дешевле, пересчитать данные или прочитать их из СХД? И как только стоимость пересчета становится выше стоимости сохранения и повторного чтения, временное состояние превращается в экономически полезный персистентный актив.
На мой взгляд, это очень важная идея не только для KV-кэша. То же самое относится к эмбеддингам, представлениям признаков, результатам предобработки, токенизированным датасетам, промежуточным состояниям моделей, результатам оценки и любым дорого вычисляемым артефактам преобразований.
И поэтому планирование емкости СХД для AI надо строить не только по росту сырых данных. Я бы записал формулу концептуально так:
Объем данных AI = исходные данные + производные данные + состояние моделей + переиспользуемое рантайм-состояние + версии + копии для хранения.
Причем последние четыре слагаемых в зрелой инфраструктуре AI вполне могут оказаться больше первого.
Объектное хранилище как единый источник данных для AI
В традиционном озере данных объектное хранилище давно используется как источник истины. Но раньше сама семантика объекта была очень простой: есть бакет, ключ объекта, содержимое, метаданные, версия и политика. Приложение знает, что находится внутри объекта. СХД обычно нет.
AI-native подход начинает размывать эту границу. СХД все чаще становится не просто контейнером для байтов, а платформой для представлений. То есть поверх базового объектного примитива появляются специализированные представления: объект S3, таблица, вектор, векторный индекс, событие, запись каталога, артефакт модели.
Именно эту эволюцию авторы презентации описывают как движение от Objects к Objects + Tables, затем к Objects + Tables + Semantic Indexes и, наконец, к AI Storage Representations.
Для меня это один из главных тезисов презентации. Мы привыкли считать базу данных и СХД разными слоями. База данных понимает структуру данных. СХД понимает блоки, файлы или объекты. Но по мере появления все более специализированных паттернов доступа AI часть функций базы данных неизбежно начинает опускаться ближе к хранилищу.
Не потому, что СХД хочет стать PostgreSQL. А потому, что перенос огромного количества данных между хранилищем и отдельными сервисами индексирования и каталогизации становится слишком дорогим. Гравитация данных начинает диктовать архитектуру.
Какие функции нужны AI-native объектному хранилищу
Для обычного S3-совместимого хранилища достаточно реализовать PUT, GET, DELETE, LIST, multipart upload и базовую объектную семантику. Для встроенного в хранилище Iceberg этого уже мало.
Нужна строгая согласованность. Нужен compare-and-swap для указателя метаданных. Нужны условные записи. Нужен высокий IOPS на мелких операциях с метаданными. Нужен встроенный REST Catalog. Нужны фоновые задачи обслуживания.
Причем часть этих примитивов уже существует в зрелых объектных платформах. Например, Amazon S3 обеспечивает строгую согласованность read-after-write для PUT/DELETE и атомарные обновления отдельных ключей. Кроме того, условные записи через If-Match позволяют обновлять объект только при совпадении его ETag, что по сути дает необходимый строительный блок для оптимистичной конкурентности и CAS-подобного поведения.
Это хороший пример того, как небольшой на первый взгляд примитив хранилища вдруг позволяет поднять гораздо более сложную семантику уровнем выше.
AI-native object storage: от хранения объектов к активной платформе данных
Если соединить Iceberg и векторы, начинает получаться совершенно новое определение объектного хранилища.
Раньше бакет содержал объекты. Теперь бакет или пространство имен потенциально содержит сырые объекты, таблицы Iceberg, метаданные таблиц, состояние каталога, векторы, векторные индексы, артефакты моделей, метаданные происхождения, события и политики жизненного цикла.
Хранилище начинает не только отвечать на GET object. Оно начинает отвечать на запросы типа: «какая версия датасета является текущей?», «найди ближайшие векторы», «переведи метаданные таблицы на новый снапшот», «перемести старый чекпоинт на емкостной уровень», «при появлении нового объекта запусти расчет эмбеддингов», «удали производные векторы после удаления исходного объекта», «сохрани предыдущую версию артефакта модели».
То есть объектное хранилище становится активным участником прикладного процесса.
На мой взгляд, это и есть настоящий смысл термина AI-native storage. Не «СХД, которая умеет быстро читать файлы для GPU», а СХД, которая понимает жизненный цикл представлений данных AI.
Метаданные AI: происхождение, версии и политики жизненного цикла данных
Дальше презентация делает еще один шаг, который я считаю чрезвычайно важным.
В традиционной презентации СХД метаданные, жизненный цикл и уведомления часто оказываются где-то в разделе «дополнительные возможности». Для AI авторы предлагают считать их архитектурными требованиями. И я полностью с этим согласен.
Почему? Потому что датасет AI без происхождения начинает быстро терять ценность.
Допустим, у меня есть эмбеддинг. Мне надо знать: из какого объекта он получен; какой версией модели эмбеддингов; когда; каким алгоритмом разбиения на чанки; какая версия исходного документа использовалась; кому принадлежит документ; какой гриф безопасности; можно ли использовать его для обучения; когда он должен быть удален; какая модель была обучена на этом датасете.
Если эти метаданные потеряны, сам вектор становится почти бесполезным. Поэтому метаданные перестают быть просто «несколькими пользовательскими заголовками у объекта». Они становятся частью графа происхождения данных.
Event-driven object storage: как события запускают AI-конвейеры
Рассмотрим простой конвейер загрузки данных для AI. Появился новый объект. Хранилище генерирует уведомление. Уведомление запускает процесс. Процесс извлекает текст, разбивает его на чанки, рассчитывает эмбеддинги, добавляет векторы в индекс, регистрирует датасет в Iceberg, обновляет метаданные и, возможно, инициирует переобучение или оценку.
В такой архитектуре событие объекта фактически первый триггер всего конвейера данных AI. Именно поэтому на слайдах SNIA рядом оказываются уведомления, метаданные и теги, версионирование, жизненный цикл, репликация и шифрование.
Я бы даже сказал, что современное объектное хранилище все больше напоминает событийно-ориентированную платформу данных. Объект не конечная точка конвейера. Объект это событие.
Версионирование данных AI: Iceberg, снапшоты и воспроизводимость моделей
Возьмем обычное обучение модели. Есть датасет v1. Затем часть документов обновили. Получился датасет v2. Из него обучили модель v2. Потом поменяли токенизатор. После этого изменили предобработку. Потом модель эмбеддингов.
Через полгода выяснилось, что модель v5 выдает нежелательное поведение. Нам нужно воспроизвести прогон обучения v3.
Без версионирования сразу возникает масса вопросов: какие именно исходные объекты входили в датасет? Какая схема использовалась? Какая версия конвейера предобработки? Какие разметки? Какие чекпоинты? Какая конфигурация?
И здесь time travel в Iceberg и версионирование объектов внезапно оказываются не просто удобной аналитической функцией. Они становятся механизмом воспроизводимости AI. Apache Iceberg позволяет выполнять запросы по историческому снапшоту и откатывать состояние таблицы к предыдущей версии. Для управления AI это очень серьезная возможность.
Почему объектное хранилище становится центром управления данными AI
Почему эту роль получает именно объектное хранилище, а не файловая система?
Потому что объект обладает несколькими полезными свойствами. Он является самодостаточной единицей. Есть ключ. Есть метаданные. Есть версионирование. Есть политика. Есть жизненный цикл. Есть репликация. Есть событие.
Очень легко сказать: «все объекты с тегом checkpoint=true после 24 часов переместить на уровень емкости». С блочной СХД это описать намного сложнее: она видит блоки и не знает, чекпоинт это или страница базы данных. Файловая система знает файл, но традиционное пространство имен POSIX не всегда предоставляет такую же богатую модель политик, особенно в облачном масштабе.
Объектная абстракция поэтому очень удобна именно как граница политик.
Data lineage для AI: как управлять зависимостями между объектами, эмбеддингами и индексами
Это направление в презентации показано скорее концептуально, но я считаю его одним из логических продолжений предложенной архитектуры.
Если вектор является производным от объекта, хранилище должно понимать зависимость: объект A → чанки B1…Bn → эмбеддинги C1…Cn → индекс D. Если объект A изменился, нужно понимать, какие C теперь устарели.
Если объект A удаляется по запросу в духе GDPR, недостаточно удалить только оригинал. Нужно удалить чанки, эмбеддинги, записи индекса, возможно производные строки таблиц, возможно кэшированные промпты и в отдельных сценариях обучающие копии.
То есть жизненный цикл перестает быть плоским. Он становится графом. Я подозреваю, что именно жизненный цикл с учетом происхождения данных станет одним из ключевых отличий платформ данных для AI.
Политики доступа к данным AI: почему безопасность перемещается в слой хранения
Сегодня безопасность часто накладывается поверх приложения. Но AI делает переиспользование данных настолько широким, что политику желательно привязывать непосредственно к данным.
Например: этот объект разрешен для RAG, но запрещен для обучения модели. Этот датасет разрешен только конкретному арендатору. Эти эмбеддинги нельзя экспортировать из региона. Эта версия модели должна храниться семь лет. Этот чекпоинт можно удалить через 30 дней. Этот датасет содержит конфиденциальную информацию.
В традиционной СХД ACL отвечает в основном на вопрос «кто может читать объект». СХД для AI начинает отвечать еще и на вопрос «что с этим объектом разрешено делать». Это гораздо более богатая модель политик.
Суверенное AI-хранилище: зачем локально хранить модели, эмбеддинги и RAG-данные
Здесь локальная архитектура получает еще один аргумент.
Векторный эмбеддинг это не просто случайные числа. Он может содержать семантическую информацию об исходных данных. Артефакт модели может содержать интеллектуальную собственность. Корпус RAG может включать внутренние документы.
Поэтому для регулируемых или суверенных сред возможность построить таблицы и векторные индексы непосредственно внутри своего ЦОД может быть крайне важна.
Именно поэтому презентация сравнивает облачную и локальную встроенную архитектуру не только по производительности и эксплуатации, но и по суверенитету данных. Мне кажется, это один из сильнейших аргументов в пользу появления локальных эквивалентов S3 Tables и S3 Vectors.
AI storage: self-managed, cloud и on-premises архитектуры
На слайде Architecture Comparison авторы выделяют три варианта.
Первый: самостоятельное управление. Каталог Iceberg отдельно. Postgres отдельно. Kubernetes отдельно. Векторная БД отдельно. СХД отдельно. Это максимально гибкая архитектура, но эксплуатационная сложность очень высокая.
Второй: управляемый гиперскейлером. S3 Tables. S3 Vectors. Минимум инфраструктурных операций, но сильная зависимость от платформы.
Третий: встроенный локальный вариант. Каталог встроен непосредственно в хранилище. Векторный индекс тоже. Обслуживание выполняется фоновыми сервисами хранилища. При этом сохраняются суверенитет данных и потенциально открытый API.
На мой взгляд, именно третий вариант станет очень интересной областью конкуренции производителей СХД.
Storage Scanner: зачем AI-native хранилищу фоновый движок обработки данных
В презентации несколько раз появляется фреймворк фонового сканера. На первый взгляд сканер скучная внутренняя подсистема СХД. Но если хранилище начинает обслуживать абстракции AI, сканер становится практически аналогом фонового движка базы данных.
Он может проверять новые объекты, обновлять индекс, выполнять компактификацию векторов, удалять устаревшие снапшоты, искать осиротевшие файлы, перестраивать манифесты, применять жизненный цикл, перемещать данные между уровнями, проверять целостность и обновлять метаданные.
То есть объектное хранилище получает целую фоновую вычислительную плоскость. И я думаю, что значение таких движков будет только расти.
Compute-to-Data: зачем AI-инфраструктуре вычисления рядом с хранилищем
Как только хранилище начинает сканировать петабайты данных, очевидно появляется вопрос: зачем каждый раз вытаскивать данные наружу? Можно выполнять часть операций непосредственно там, где данные лежат: сжатие, контрольные суммы, разбиение на чанки, фильтрацию, генерацию эмбеддингов, извлечение метаданных, обслуживание индекса.
Я не думаю, что объектное хранилище начнет массово выполнять полноценный LLM-инференс внутри дисковой полки. Но простые преобразования данных вполне логично переносить ближе к хранилищу. Это возвращает старую идею computational storage, только в новом контексте AI.
DPU в AI-хранилище: разгрузка CPU и ускорение обработки данных
В повестке презентации отдельно упоминаются DPU. Хотя в самих слайдах тема раскрыта заметно меньше, чем KV-кэш или S3, логика их применения понятна.
DPU или SmartNIC может снять с CPU хоста часть сетевой обработки, RDMA, шифрования, сжатия, перемещения данных и обработки протоколов хранения. В узле AI CPU уже не обязательно должен быть главным перемещателем данных. GPU очень дорогой ускоритель. CPU нужен для оркестрации. И тратить его циклы на копирование буферов между сетью и памятью ускорителя не всегда разумно.
Поэтому DPU становится частью оптимизированного пути данных от хранилища к GPU.
Семантика данных и транспорт: как строится современная AI storage architecture
Я считаю, что это принципиальный архитектурный паттерн всей презентации.
На уровне приложения мы хотим стабильную семантику: объект S3, таблица Iceberg, векторный индекс, блок KV. А транспорт под ними может эволюционировать: HTTP/TCP сегодня, RDMA завтра, ввод-вывод, инициируемый GPU, послезавтра, NVMe-oF для одного уровня, локальный PCIe для другого.
Приложение не должно переписывать бизнес-логику каждый раз, когда меняется сетевой транспорт. И именно поэтому стандарты чрезвычайно важны.
Роль SNIA в развитии стандартов AI storage
Вендор может сделать потрясающе быстрый проприетарный протокол объектов поверх RDMA. Но если он работает только с одной СХД и одной клиентской библиотекой, экосистема практически не развивается.
Нужны общая семантика данных, протокол обмена, регистрация памяти, обнаружение, аутентификация, обработка ошибок, откат на запасной путь и согласование возможностей. И здесь роль SNIA как организации по стандартизации вполне естественна. Техническая рабочая группа SNIA Accelerated Object I/O как раз занимается стандартизацией такого класса интерфейсов.
Если S3 поверх RDMA действительно станет интероперабельным, это может быть для высокопроизводительного объектного хранилища примерно тем же, чем когда-то NVMe-oF стал для блочных СХД.
Главный принцип AI-native storage: семантика данных сверху, оптимальное размещение снизу
После разбора презентации я бы нарисовал современный фундамент данных AI следующим образом.
В самом верху находятся приложения: обучение, инференс, RAG, агенты, аналитика, инженерия признаков. Ниже располагается семантический слой данных: объекты, таблицы, векторы, артефакты моделей, объекты KV, события, метаданные, жизненный цикл. Ниже слой доступа: S3, S3/RDMA, Iceberg REST, векторный API, NFS/pNFS, POSIX, NVMe-oF. Ниже интеллектуальное размещение: горячее, теплое, холодное, архив. И только в самом низу находятся физические носители: HBM, DRAM, NVMe, SSD, HDD, SMR.
Это полная инверсия традиционного проектирования продуктов хранения. Мы больше не начинаем с вопроса «у нас есть массив NVMe, что на него положить?». Мы начинаем с вопроса «какие представления данных создает приложение и каков жизненный цикл каждого из них?». И только потом выбираем носитель.
Что важно учитывать при оценке AI-native storage: ограничения и допущения
Несмотря на то что общий архитектурный тезис мне кажется очень сильным, несколько моментов я бы не принимал буквально.
Во-первых, не существует универсального правила «HDD для обучения, NVMe для предобработки». Реальное размещение нагрузки зависит от профиля ввода-вывода.
Во-вторых, вендорские цифры производительности по выгрузке KV нельзя переносить на любую модель. Доля попаданий в кэш, длина контекста, архитектура GPU и топология сети полностью меняют экономику.
В-третьих, S3 Vectors не означает автоматического исчезновения выделенных векторных БД.
В-четвертых, встроенный каталог и индекс уменьшают эксплуатационную сложность, но одновременно увеличивают сложность самой платформы хранения. Кто-то все равно должен реализовать высокую доступность, согласованность, восстановление, резервное копирование, безопасность, обновления и восстановление индекса. Просто ответственность перемещается от пользователя к вендору.
И наконец, SMR подходит далеко не всем нагрузкам AI. Он хорош именно там, где приложение или слой хранения способны адаптировать записи под зонное, дружественное к дозаписи поведение.
Куда развивается объектное хранилище в эпоху AI
Если убрать вендорские детали, остается очень стройная последовательность.
AI создает огромное количество производных данных. Производные данные должны жить рядом с исходными. Для них нужна разная семантика доступа. Перемещать их между отдельными системами дорого. Значит, СХД будет поглощать часть сервисов данных.
Но физические требования разных представлений радикально различаются. Следовательно, СХД будет становиться многоуровневой. Чтобы многоуровневость не просачивалась в приложение, нужен стабильный семантический слой и слой API. Чтобы быстрый уровень действительно был быстрым, нужен ускоренный транспорт. А чтобы инференс масштабировался экономически, переиспользуемое рантайм-состояние тоже начинает уходить в хранилище.
Вот и получается архитектура из презентации.
Итог: объектное хранилище становится фундаментом AI Data Platform
Раньше конвейер выглядел примерно так: приложение → обработка → результат → объектное хранилище. Объектное хранилище было последним этапом, складом результата.
В новой модели оно находится практически в центре: объектное хранилище ↔ загрузка ↔ аналитика ↔ Iceberg ↔ эмбеддинги ↔ векторный поиск ↔ обучение ↔ инференс ↔ переиспользование KV ↔ архив.
То есть хранилище становится не конечным пунктом назначения, а общей фабрикой данных для всего жизненного цикла AI. Мне кажется, именно эту мысль лучше всего вынести из презентации SNIA.
Объектное хранилище не исчезнет под натиском AI. Наоборот, оно становится гораздо важнее. Но чтобы оставаться фундаментом инфраструктуры AI, ему придется эволюционировать.
Недостаточно научиться хранить триллионы объектов. Нужно понимать таблицы. Нужно понимать векторы. Нужно уметь работать с метаданными как с полноценными данными. Нужно управлять жизненным циклом. Нужно поддерживать строгую согласованность и атомарные операции. Нужно автоматизировать обслуживание. Нужно обеспечивать быстрый путь к памяти ускорителя. Нужно уметь использовать NVMe там, где критична задержка, а HDD и SMR там, где решающей является экономика емкости. И, возможно, СХД придется научиться работать даже с тем, что еще недавно вообще не считалось данными для хранения, например с KV-кэшем.
Что меняется в архитектуре СХД с появлением AI
AI превращает СХД из системы хранения данных в систему управления представлениями данных.
Объект больше не единственное представление. У нас есть объект. Таблица. Вектор. Модель. Чекпоинт. Состояние KV. И платформа хранения должна понимать, как они связаны, где должны находиться, насколько быстро должны быть доступны, сколько времени должны храниться и когда их можно перемещать на более дешевый уровень.
А идеальная архитектура при этом должна сохранять иллюзию простоты для приложения. Разработчик работает с объектом, таблицей или вектором. Он не обязан знать, что конкретно сейчас лежит на HBM, NVMe, QLC, HDD или SMR. Это должна решать инфраструктура.
Поэтому последний тезис слайда Mixed-Fleet Object Architecture мне кажется лучшим завершением всей темы: object semantics above, workload-aware placement below.
И, пожалуй, именно так сегодня стоит проектировать фундамент данных AI: одна семантика данных сверху, множество специализированных уровней хранения снизу и максимально быстрый путь данных между ними и вычислениями.
Источники
- SNIA, страница вебинара: https://www.snia.org/educational-library/architecting-ai-data-foundations-object-storage-patterns-scale-access-and
- SNIA, презентация (43 слайда): https://www.snia.org/sites/default/files/CSI/Architecting-AI-Data-Foundations.pdf
- SNIA Q&A: Architecting AI Data Foundations: https://www.snia.org/blog/2026/architecting-ai-data-foundations-qa
- Документация Apache Iceberg: https://iceberg.apache.org/
- Документация Amazon S3 Tables: https://docs.aws.amazon.com/AmazonS3/latest/userguide/s3-tables.html
- Amazon S3 Vectors: https://aws.amazon.com/s3/features/vectors/
- Microsoft Research: DiskANN / Project Akupara: https://www.microsoft.com/en-us/research/project/project-akupara-approximate-nearest-neighbor-search-for-large-scale-semantic-search/
- Документация NVIDIA Dynamo: https://docs.nvidia.com/dynamo/
Редакционная оговорка. Текст является авторским техническим разбором и интерпретацией материалов SNIA, а не стенограммой. Численные результаты из вендорских материалов следует читать как результаты конкретных тестовых конфигураций, а не как универсальные гарантии производительности.
Автор: Андрей Гантимуров