AI Data Pipeline: как устроен конвейер хранения данных от загрузки до архива
В предыдущих материалах мы разобрали, как AI меняет архитектуру объектного хранения, почему NVMe, SSD, HDD и SMR занимают разные места в инфраструктуре, как Iceberg и векторные хранилища расширяют возможности S3 и почему KV-cache превращает storage в часть системы памяти. Теперь посмотрим на задачу шире — на весь конвейер обработки данных для ИИ. На каждом этапе, от загрузки исходных данных до обучения моделей, инференса и архивирования, возникают свои требования к производительности, задержкам, протоколам доступа и стоимости хранения. Почему универсального уровня хранения здесь недостаточно, как должны взаимодействовать объектные и параллельные файловые системы и каким может быть архитектурный фундамент AI-native инфраструктуры — разберем на примере концепции The AI Data Pipeline.
Подробный авторский разбор вебинара SNIA «Architecting AI Data Foundations: Object Storage Patterns for Scale, Access, and Longevity» (29 июля 2026 года). Иллюстрации воспроизводят содержание ключевых слайдов SNIA в редакционном оформлении; источник указан под каждой схемой.
AI Data Pipeline: от загрузки до архива
Ближе к концу презентации есть еще один очень полезный слайд, The AI Data Pipeline. Авторы делят конвейер на загрузку → предобработку → обучение → инференс → архив и для каждой стадии предлагают свою сигнатуру хранения.
Это крайне правильный подход. Я бы только не воспринимал конкретные протоколы на слайде как жесткое правило. Например, обучение далеко не всегда обязано идти через pNFS, а предобработка именно через NVMe-oF. Ценность слайда не в этом.
Ценность в идее: каждый этап конвейера AI создает принципиально другой профиль ввода-вывода.
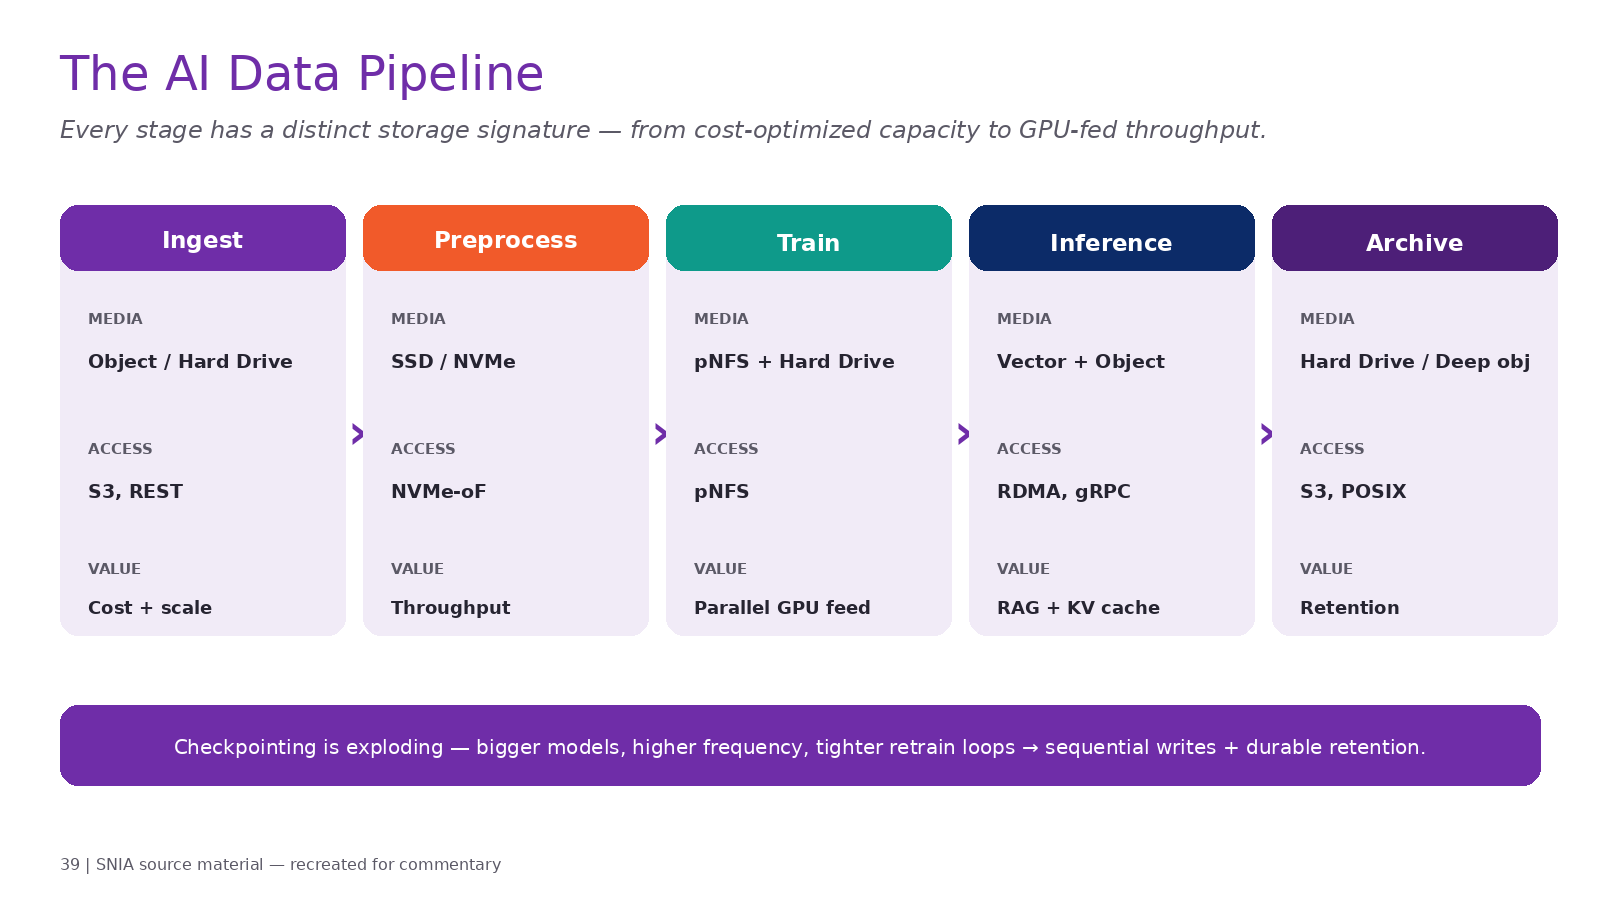
Рисунок 6. Конвейер данных AI и различные сигнатуры хранения этапов загрузки, предобработки, обучения, инференса и архива. По материалам SNIA, слайд 39.
Хранение данных на этапе загрузки AI-конвейера
Загрузка обычно ориентирована на емкость, параллельность, крупные записи и сохранность. Источники могут быть самыми разными: логи, документы, изображения, видео, потоки IoT, выгрузки из баз данных, научные данные.
Здесь S3 и объектное хранилище практически идеальны. Задержка отдельного PUT обычно не является главным параметром. Важно масштабироваться, принимать поток, сохранять данные надежно и дешево удерживать их долго. Поэтому загрузка хорошо ложится на объектную емкость на HDD.
Хранение данных на этапе предобработки AI
Предобработка выглядит совершенно иначе. Данные уже нужно активно читать. Распаковывать. Декодировать. Нормализовать. Разбивать на чанки. Токенизировать. Перемешивать. Аугментировать. Конвертировать.
Возможно, тысячи воркеров одновременно читают вход и создают производные данные. Здесь задержка и IOPS начинают иметь гораздо большее значение. Промежуточный уровень на NVMe становится очень полезным, особенно если предобработка выполняется прямо перед обучением и повторяется много раз.
СХД для обучения AI-моделей: требования к производительности
Обучение совершенно другой мир. Главная задача СХД: не дать GPU ждать.
Если кластер содержит сотни или тысячи GPU, даже несколько процентов простоя превращаются в огромные деньги. Нагрузка обучения может включать высокопараллельное последовательное чтение, случайный доступ к сэмплам, интенсивные операции open/stat с метаданными, запись чекпоинтов и перемешивание датасета.
Поэтому производительность СХД нужно оценивать не по красивому максимальному GB/s. Гораздо полезнее вопрос: при каком количестве GPU СХД перестает поддерживать целевую утилизацию GPU? Это гораздо более честная метрика.
Хранение чекпоинтов AI-моделей: NVMe, HDD и автоматический tiering
Чекпоинтинг заслуживает отдельного внимания. Модель становится больше. Количество GPU увеличивается. Частота чекпоинтов растет. Домен отказа растет. Стоимость потерянного времени обучения растет.
В результате чекпоинт очень необычная нагрузка: гигантская пиковая запись, которую нужно быстро закончить, после чего чекпоинт может лежать практически без обращений, но его необходимо надежно сохранить.
Поэтому возникает очевидная гибридная архитектура. Записать чекпоинт быстро на уровень NVMe. Затем в фоне мигрировать на емкость HDD или объектов. Следующий чекпоинт снова принимается на быстрый уровень. Это гораздо дешевле, чем держать всю историю чекпоинтов на NVMe.
И здесь политика жизненного цикла непосредственно становится функцией производительности.
Хранилище для AI-инференса: модели, RAG, KV-кэш и векторы
Инференс снова радикально меняет паттерн. Веса модели. Векторный поиск. Поиск для RAG. KV-кэш. Данные промптов. Мелкий случайный доступ. Чувствительные к задержкам метаданные. Общий контекст.
Это уже смешанная нагрузка. Часть требует HBM. Часть DRAM. Часть NVMe. Часть объектов. Поэтому инференс, возможно, является самой интересной нагрузкой с точки зрения многоуровневого хранения.
Здесь СХД перестает быть просто поставщиком файлов модели. Она начинает активно участвовать в пути обработки запроса.
Архивное хранение данных AI: стоимость, HDD, SMR и долговременное хранение
Наконец архив. Обучающие данные часто нельзя просто удалить после окончания обучения. Нужно обеспечить воспроизводимость, соответствие регуляторным требованиям, аудит моделей, защиту интеллектуальной собственности, переобучение и расследования. Но вероятность регулярного доступа крайне мала.
Следовательно, архивный уровень должен оптимизироваться почти исключительно под $/TB, сохранность, плотность и энергоэффективность. И здесь HDD и SMR полностью естественны.
S3 или POSIX: почему AI-инфраструктуре нужны оба протокола
При этом я бы не делал из презентации вывод «S3 победит файловую систему». Нет.
Конвейер AI чрезвычайно неоднороден. Есть приложения, ожидающие POSIX. Есть высокопроизводительные нагрузки обучения, отлично работающие через параллельную файловую систему. Есть GPUDirect Storage. Есть фреймворки чекпоинтинга, ориентированные на файловую семантику. Есть огромное количество унаследованного ПО.
Поэтому реалистичная архитектура это не S3 вместо POSIX. Это единый фундамент данных с несколькими протоколами доступа: объекты, NFS, pNFS, POSIX, S3, объекты поверх RDMA, NVMe-oF, векторный API, Iceberg REST.
И тогда главной задачей СХД становится согласованность между этими режимами доступа.
Мультипротокольное AI-хранилище: S3, POSIX, NFS, NVMe-oF и Iceberg
Если один датасет одновременно виден по файловому и объектному протоколу, появляется масса сложных вопросов.
Кто владеет пространством имен? Как синхронизируются метаданные? Можно ли изменить файл через POSIX и сразу увидеть новый объект? Как формируется ETag? Что происходит с версионированием объектов? Как обеспечивается атомарность? Можно ли через S3 изменить объект, который открыт через NFS? Как отрабатывают блокировки? Если поверх тех же данных есть Iceberg, кто отвечает за согласованность? Если существует производное векторное представление, когда оно инвалидируется?
Вот здесь AI-native фундамент данных становится действительно сложной задачей проектирования СХД.
Объектное хранилище и параллельная файловая система: как они дополняют друг друга
При этом очень важно не впасть в другую крайность. Из презентации может сложиться ощущение: «все станет S3». Я так не думаю.
Параллельные файловые системы прекрасно решают множество нагрузок обучения, особенно когда нужны общее пространство имен, производительность на мелких файлах, POSIX, высокопараллельное потоковое чтение и зрелая интеграция с HPC.
Но объектное хранилище имеет огромные преимущества для долговременных датасетов, облачных приложений, жизненного цикла, глобального пространства имен, метаданных, версионирования, событийных конвейеров и экономики емкости.
Поэтому, скорее всего, победит конвергентная архитектура. Один фундамент данных. Несколько «личностей» доступа. И интеллектуальное многоуровневое хранение между ними.
Источники и дополнительное чтение
- SNIA, страница вебинара: https://www.snia.org/educational-library/architecting-ai-data-foundations-object-storage-patterns-scale-access-and
- SNIA, презентация (43 слайда): https://www.snia.org/sites/default/files/CSI/Architecting-AI-Data-Foundations.pdf
- SNIA Q&A: Architecting AI Data Foundations: https://www.snia.org/blog/2026/architecting-ai-data-foundations-qa
- Документация Apache Iceberg: https://iceberg.apache.org/
- Документация Amazon S3 Tables: https://docs.aws.amazon.com/AmazonS3/latest/userguide/s3-tables.html
- Amazon S3 Vectors: https://aws.amazon.com/s3/features/vectors/
- Microsoft Research: DiskANN / Project Akupara: https://www.microsoft.com/en-us/research/project/project-akupara-approximate-nearest-neighbor-search-for-large-scale-semantic-search/
- Документация NVIDIA Dynamo: https://docs.nvidia.com/dynamo/
Редакционная оговорка. Текст является авторским техническим разбором и интерпретацией материалов SNIA, а не стенограммой. Численные результаты из вендорских материалов следует читать как результаты конкретных тестовых конфигураций, а не как универсальные гарантии производительности.
Автор: Андрей Гантимуров