Apache Iceberg, S3 Tables и S3 Vectors: как обычное объектное хранилище превращается в платформу данных для AI
В предыдущей статье «AI-native object storage: как меняется архитектура хранения данных для ИИ» мы посмотрели на эту проблему сверху: почему AI постепенно превращает объектное хранилище из простого слоя хранения в платформу, которая должна понимать разные представления данных — объекты, таблицы, эмбеддинги, индексы и метаданные.
В этой статье предлагаю посмотреть на ту же архитектуру с другой стороны — через способы доступа к данным. Для AI недостаточно просто хранить один и тот же набор объектов. Одним приложениям нужен точный структурный запрос по таблице, другим — поиск по смысловой близости в векторном пространстве. А часто один запрос требует и того, и другого одновременно.
Именно поэтому таблицы и векторы становятся особенно интересной парой для объектного хранилища. Они показывают, как storage постепенно начинает брать на себя функции, которые раньше находились в отдельных аналитических, каталоговых и векторных системах.
Табличный и векторный поиск: зачем AI нужны оба типа данных
Таблицы отвечают на точно сформулированные вопросы. Например: SELECT * FROM Orders WHERE Customer = 123. Здесь я знаю критерий поиска. Мне нужен клиент с ID 123. SQL прекрасно описывает операцию.
Векторы отвечают на совершенно другой класс вопросов: «Найди документы, похожие по смыслу на это сообщение об ошибке». У меня нет точного ключа. Нет WHERE error = something. Есть многомерное представление смысла запроса, и нужно найти ближайшие представления других объектов. Поэтому используется приближенный поиск ближайших соседей (ANN).
И авторы делают важный вывод: корпоративному AI нужны оба способа доступа одновременно.
Мне эта мысль особенно нравится применительно к RAG. В массовом обсуждении RAG иногда создается ощущение, что векторная БД заменяет все остальное. На практике очень часто нужен гибридный поиск.
Например, пользователь спрашивает: «Найди похожие инциденты для серверов клиента X за последние три месяца». Первая часть запроса структурная: customer = X, date > now — 90 days. Ее прекрасно выполняет табличный движок. А вторая часть, «похожие инциденты», уже семантическая и требует векторного поиска.
В официальном Q&A к этому вебинару SNIA приводит практически ту же архитектурную идею: сначала таблица может ограничить датасет конкретным клиентом или набором транзакций, а затем векторный поиск выполняет семантический отбор уже внутри полученного множества.
И вот здесь становится понятно, почему объектное хранилище начинает интересоваться и таблицами, и векторами. Физически исходные данные очень часто уже лежат именно там.
Apache Iceberg и объектное хранилище: как устроено AI-озеро данных
Первый большой пример этого сближения в презентации Apache Iceberg.
Iceberg это открытый табличный формат для больших аналитических датасетов. Он позволяет нескольким вычислительным движкам работать с одними и теми же табличными данными, лежащими в объектном хранилище. Spark, Trino, Flink и другие движки могут обращаться к одному датасету, не заставляя владельца данных мигрировать их под конкретную СУБД. Apache Iceberg поддерживает эволюцию схемы, эволюцию партиционирования, снапшоты, time travel, оптимистичную конкурентность и REST Catalog.
Здесь важно понимать: Iceberg не является новым форматом файлов вроде Parquet. Parquet отвечает за внутреннее колоночное представление конкретного файла данных. Iceberg отвечает за структуру таблицы как множества файлов и их версий. Это радикально разные уровни.
В упрощенном виде таблица Iceberg состоит из нескольких слоев. Внизу находятся файлы данных, чаще всего Parquet. Над ними манифесты, которые содержат информацию о файлах данных, значениях партиций и статистике. Над манифестами список манифестов. Выше располагается снапшот. И наконец, метаданные таблицы указывают на актуальное состояние таблицы.
При обновлении таблицы Iceberg не переписывает петабайты старых Parquet-файлов. Вместо этого создаются новые неизменяемые файлы и новое состояние метаданных. Коммит переводит указатель таблицы на новую версию.
Apache прямо описывает состояние таблицы как файлы метаданных, а каждое изменение состояния создает новый файл метаданных с атомарной заменой текущего указателя. Именно благодаря этому читатели видят либо старое состояние таблицы, либо новое, но не половину транзакции.
Почему Apache Iceberg подходит для объектного хранилища
Это архитектурно очень красивое совпадение.
Объектное хранилище любит неизменяемые объекты. Iceberg любит неизменяемые файлы. Объектное хранилище не особенно любит произвольные мелкие перезаписи на месте. Iceberg практически не требует их от файлов данных.
Вместо «открой большой файл и поменяй блоки внутри» мы получаем: «запиши новые неизменяемые файлы и атомарно переключи указатель метаданных». Это намного естественнее для мира S3.
Из-за этого многие старые ограничения объектного хранилища перестают быть проблемой. Например, для традиционной таблицы, ориентированной на файловую систему, может быть важна атомарная операция переименования. Iceberg в значительной степени уходит от этого паттерна и строит согласованность через метаданные и коммиты.
В результате можно хранить огромное количество аналитических данных в дешевом масштабируемом объектном хранилище и одновременно получать семантику уровня базы данных. Именно поэтому Iceberg стал настолько важной частью современных lakehouse-архитектур.
Iceberg Catalog: зачем таблицам каталог и метаданные
И вот здесь презентация становится особенно интересной.
Авторы раскладывают таблицу Iceberg на три архитектурных слоя. Внизу данные таблицы. Выше метаданные. А затем каталог.
Данные и метаданные уже прекрасно живут в объектном хранилище. Но каталог остается отдельной инфраструктурной ответственностью. И с каталогом начинаются эксплуатационные сложности.
Нужно где-то запускать REST-сервис. Нужно хранить состояние каталога. Нужна база данных. Нужна высокая доступность. Нужны аутентификация и авторизация. Нужны Kubernetes или виртуальные машины. Нужно заниматься истечением снапшотов. Удалять осиротевшие файлы. Компактировать манифесты. Компактировать файлы данных. Следить за конкуренцией при коммитах. Контролировать рост метаданных.
Apache Iceberg действительно требует регулярного обслуживания: снапшоты накапливаются, старые желательно удалять по сроку, осиротевшие файлы вычищать, файлы данных и манифесты периодически компактировать или переписывать.
И тут авторы презентации задают очень правильный вопрос: если данные уже находятся в хранилище и метаданные находятся в хранилище, почему каталог тоже не сделать частью платформы хранения?
Это и есть переход от объектного хранилища как «тупой емкости» к объектному хранилищу как инфраструктуре данных.
Amazon S3 Tables: как AWS интегрирует Iceberg с объектным хранилищем
AWS уже сделал именно это через Amazon S3 Tables.
S3 Tables вводят отдельный тип бакета, table bucket, внутри которого таблицы являются управляемыми ресурсами и хранятся в формате Apache Iceberg. S3 выполняет часть обслуживания таблиц автоматически, включая оптимизацию, компактификацию и управление снапшотами. AWS также предоставляет Iceberg REST endpoint для прямой работы клиентов Iceberg.
То есть AWS фактически говорит: раньше мы давали вам объектное хранилище, а вы поверх него сами разворачивали каталог Iceberg, сами поднимали базу данных, сами настраивали компактификацию, сами управляли жизненным циклом снапшотов. Теперь часть этого можно включить непосредственно в сервис хранения.
Мне кажется, это фундаментально важнее, чем просто новая функция AWS. Это показатель направления всей индустрии.
Именно поэтому в презентации SNIA появляется идея on-premises аналога. Не обязательно копировать внутреннюю реализацию AWS. Важно скопировать архитектурный паттерн.
Локальное объектное хранилище может иметь Iceberg REST Catalog, атомарные коммиты метаданных, фоновый сканер, движок компактификации, очистку снапшотов, NVMe-уровень для метаданных, строгую согласованность и условные записи.
После этого Iceberg становится не внешней системой, которая случайно хранит свои Parquet-файлы в S3, а полноценной абстракцией, встроенной в хранилище.
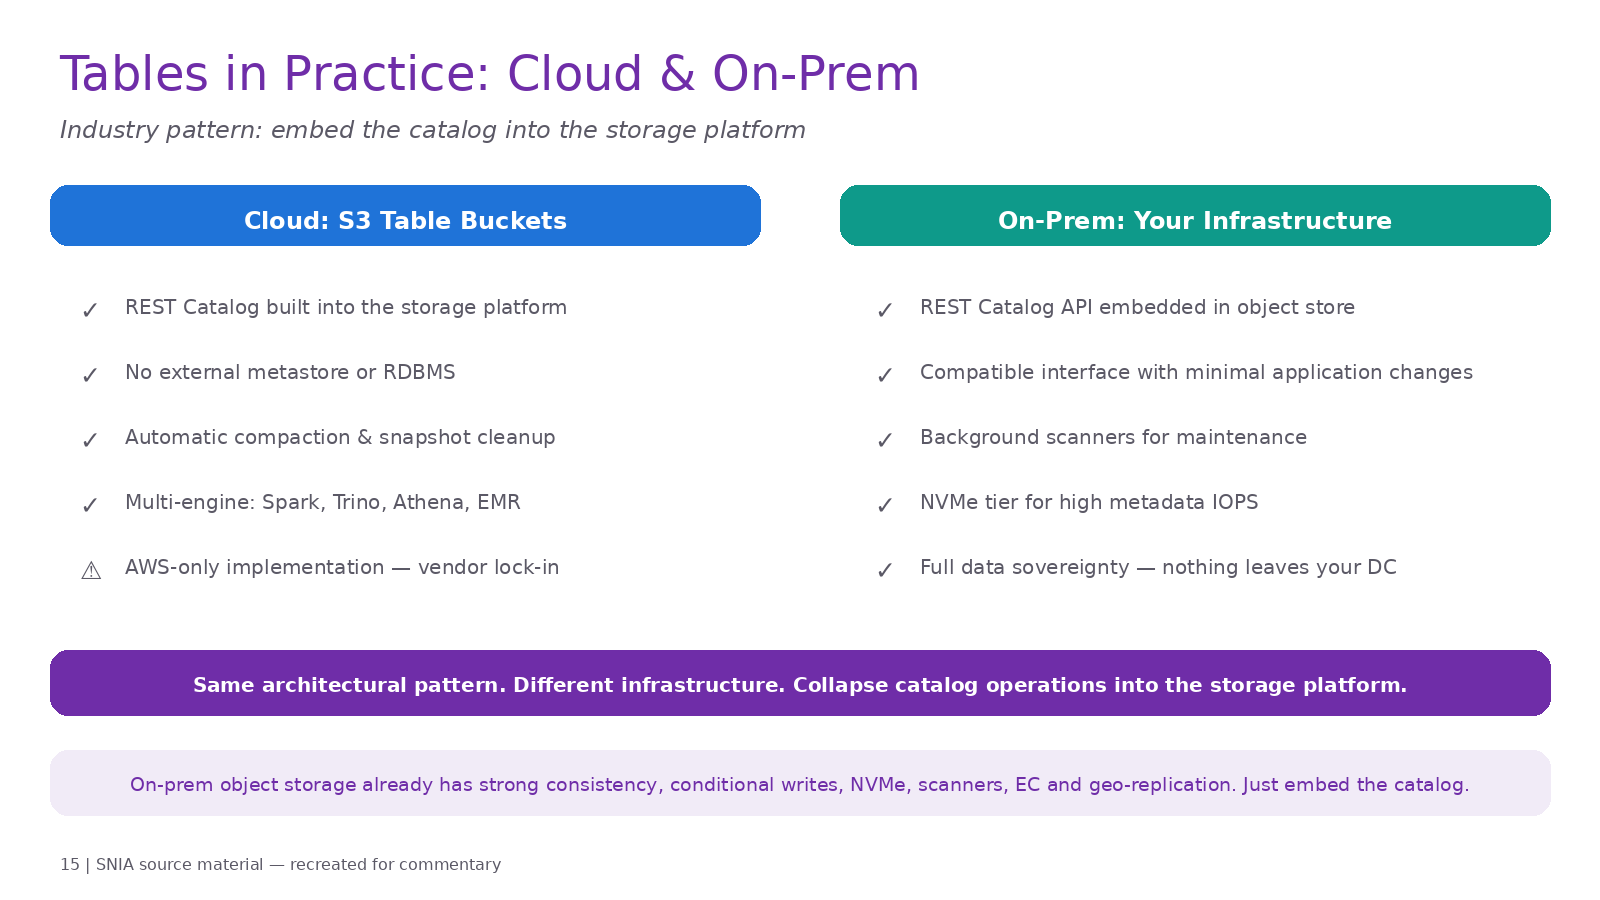
Рисунок 2. Встраивание каталога Iceberg в платформу хранения: облачные S3 Tables и on-prem паттерн. По материалам SNIA, слайд 15.
Векторные данные в объектном хранилище: следующий этап AI storage
После таблиц презентация делает еще один шаг. Если хранилище может непосредственно понимать табличное представление, почему бы ему не понимать векторное?
И вот здесь начинается, на мой взгляд, самая интересная часть всей истории.
Эмбеддинги стали базовой инфраструктурной сущностью практически любого конвейера RAG или семантического поиска. Берем объект, например PDF. Разбиваем на чанки. Каждый чанк прогоняем через модель эмбеддингов. Получаем вектор, допустим, размерности 768, 1024, 1536, 3072 или больше. Этот вектор представляет семантическую позицию объекта в многомерном пространстве.
Пользовательский запрос также превращается в вектор. Затем выполняется поиск ближайших соседей: нужно найти векторы, максимально близкие к вектору запроса по косинусной близости, евклидову расстоянию или скалярному произведению. Это классическая задача ANN, приближенного поиска ближайших соседей.
И сегодня ее чаще всего решает отдельная векторная БД.
Векторная БД или объектное хранилище: где хранить эмбеддинги
У такого подхода есть очевидная архитектурная цена.
Исходный объект уже лежит в объектном хранилище. Чанк тоже часто хранится там или в отдельной базе. Эмбеддинги попадают еще в одну систему. Векторный индекс находится еще где-то. Метаданные могут находиться в PostgreSQL. Прикладной слой должен синхронизировать несколько плоскостей данных.
При изменении исходного объекта необходимо обнаружить изменение, пересоздать чанки, пересчитать эмбеддинги, обновить индекс, удалить устаревшие векторы и обновить метаданные. Это уже серьезная задача управления распределенными данными.
И здесь снова появляется гравитация данных. Эмбеддинг не имеет самостоятельного смысла без исходного объекта. Это производное представление. Если объект удален или изменен, эмбеддинг должен каким-то образом следовать за его жизненным циклом.
Поэтому презентация формулирует довольно сильный тезис: индекс должен жить там, где уже лежат объекты.
Я бы сказал немного мягче. Векторный индекс не обязательно физически должен жить на тех же дисках. Но его жизненный цикл, метаданные и пространство имен должны быть максимально тесно связаны с жизненным циклом исходных объектов.
И тогда идея векторов, встроенных в хранилище, действительно начинает выглядеть логично.
Amazon S3 Vectors: что такое векторное хранилище и зачем оно нужно
AWS уже пошел именно по этому пути.
Amazon S3 Vectors предоставляет векторные бакеты и специализированные API для хранения и поиска векторов непосредственно как управляемый сервис хранения. AWS заявляет масштаб до миллиардов векторов на индекс и позиционирует S3 Vectors как емкостной персистентный векторный уровень с более низкой стоимостью по сравнению с подходами, требующими много памяти. Для архитектурного разговора здесь важна не конкретная цифра, а само появление новой абстракции хранения.
Важно не воспринимать это как утверждение, что S3 Vectors «убивает Pinecone, Milvus или Weaviate». Это разные классы систем. Выделенная векторная БД может предлагать более богатую семантику запросов, более низкую задержку, гибкую стратегию индексирования и более сложный гибридный поиск.
Но появляется новый слой: емкостное векторное хранилище. И это, на мой взгляд, очень важная категория.
По аналогии с обычными носителями: DRAM не уничтожила SSD, SSD не уничтожили HDD, HDD не уничтожили ленты. Они просто занимают разные точки на кривой задержки, емкости и стоимости.
То же самое может произойти с векторами. Горячие векторы можно держать в RAM или специализированной векторной БД с низкой задержкой. Теплые на NVMe. Холодный или огромный векторный корпус непосредственно в объектном хранилище. И приложение при этом может видеть единый API.
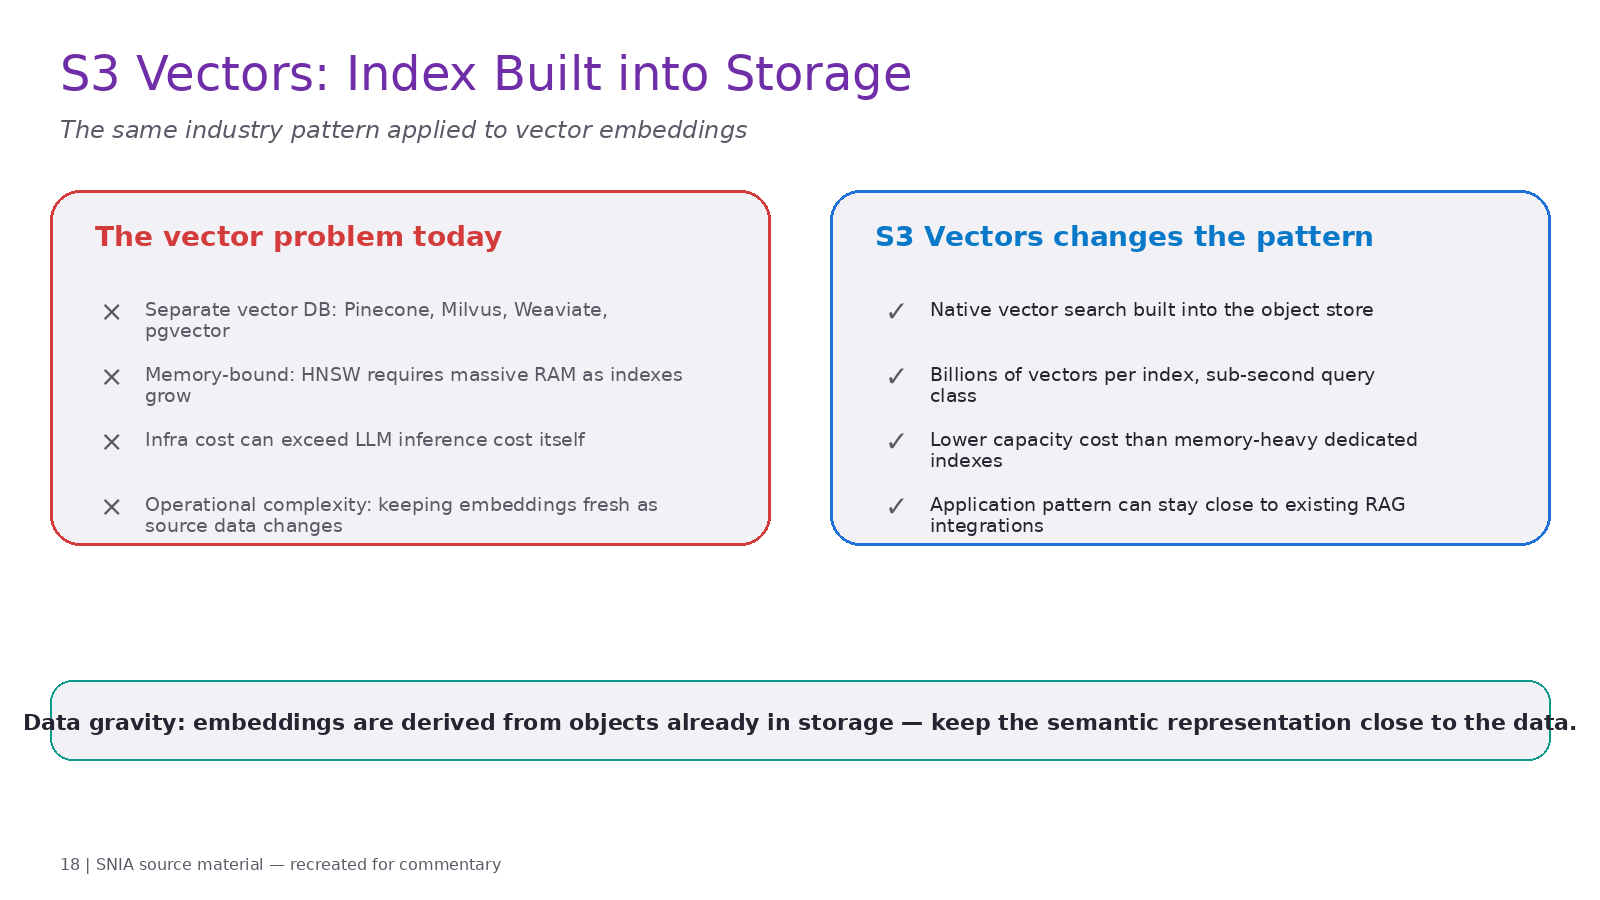
Рисунок 3. Векторный индекс, встроенный в хранилище, как альтернатива полностью внешней векторной БД. По материалам SNIA, слайд 18.
HNSW и DiskANN: какой индекс подходит для масштабного векторного поиска
Здесь возникает очень важный технический вопрос. Если индекс переносится ближе к хранилищу, нельзя просто взять любой существующий алгоритм векторного индексирования.
Самый распространенный сегодня вариант HNSW, Hierarchical Navigable Small World. HNSW строит многоуровневый граф. Каждый вектор связан с несколькими соседями. Во время поиска алгоритм перемещается по графу в направлении все более подходящих кандидатов.
HNSW обеспечивает прекрасное соотношение задержки и recall, но имеет проблему: граф любит RAM. А RAM дорогая. Если у меня десятки миллионов векторов, нормально. Если миллиарды, объем памяти становится архитектурным ограничением.
Поэтому в презентации появляется DiskANN. DiskANN изначально разрабатывался Microsoft Research именно как ANN-архитектура, способная держать существенно больше данных на SSD, оставляя в DRAM только небольшую часть структуры.
И вот здесь начинается важное совместное проектирование. Векторный движок, встроенный в хранилище, должен оптимизировать алгоритм под иерархию: DRAM, NVMe, возможно емкостные SSD и уровень HDD или объектов. Вместо того чтобы пытаться засунуть весь индекс в память, можно хранить компактное представление или квантованные коды в RAM, а полные векторы на NVMe.
Это ровно тот подход, который обсуждается в презентации SNIA.
Product Quantization: как сжимать векторы для масштабного AI-поиска
В презентации есть пример: вектор размерности 768 при float32 занимает примерно 3 KB. Действительно: 768 × 4 байта = 3072 байта. Если у меня миллиард таких векторов: 3072 × 1 000 000 000 ≈ 3 TB. Только сырые векторы. Без ребер графа. Без метаданных. Без привязки к объектам. Без накладных расходов индекса.
Если весь такой датасет пытаться обслуживать из DRAM, экономика быстро становится неприятной. Поэтому применяется квантование.
Один из вариантов Product Quantization. Вектор делится на подвекторы. Для каждого подвектора ищется ближайший центроид из кодовой книги. Вместо исходных координат с плавающей точкой хранится набор идентификаторов центроидов. Это резко уменьшает объем.
При поиске сначала используется сжатое представление для быстрой генерации кандидатов, а затем для выбранного набора кандидатов можно считать более точное расстояние по полным векторам. То есть появляется классический двухуровневый паттерн: дешевая приближенная фильтрация, затем дорогое точное переранжирование.
Для архитектуры хранения это крайне удобно. Компактное представление можно держать в RAM. Полные векторы на NVMe. Исходные объекты на HDD или емкостном объектном уровне. И мы получаем многоуровневую семантическую иерархию хранения.
On-premises векторное хранилище: как построить S3 Vectors внутри ЦОД
SNIA не останавливается на AWS.
На следующем слайде авторы буквально рисуют: AI-агенты / RAG / семантический поиск → локальное объектное хранилище со встроенным векторным индексом → NVMe / erasure coding / георепликация.
В качестве возможного подхода к индексированию называется DiskANN на NVMe. Также предлагается паттерн API, совместимый с S3 Vectors, фоновый оптимизатор и NVMe-oF для независимого масштабирования хранилища.
Вот здесь я бы сделал очень важную оговорку. Это не означает, что уже существует общий стандарт «S3 Vectors», поддерживаемый всеми вендорами так же, как классический S3 API. AWS S3 Vectors это конкретный сервис и API.
Но архитектурное направление совершенно понятно. Если на рынке появятся совместимые реализации семантики векторных бакетов, может возникнуть новый слой переносимости: LangChain или другой фреймворк обращается к векторному API; облачный бэкенд реализует его через сервис гиперскейлера; локальный бэкенд через собственный движок на DiskANN или другом графе; прикладной конвейер при этом принципиально не меняется.
И вот это было бы уже очень серьезным изменением архитектуры данных AI.
S3 Tables и S3 Vectors: почему объектное хранилище становится платформой AI-данных
Можно посмотреть на эти технологии как на очередные облачные сервисы. Мне кажется, это слишком узкий взгляд.
Они показывают изменение самой границы между базой данных и хранилищем. Хранилище постепенно начинает понимать табличную транзакцию, снапшот, вектор, запрос по близости, жизненный цикл и событие. То есть все больше интеллекта управления данными опускается вниз.
Я не ожидаю, что объектное хранилище превратится в универсальную базу данных. Но вижу очень явное движение к data-aware СХД. И AI является идеальным катализатором этого процесса, потому что объемы настолько велики, что внешнее перемещение данных становится главным узким местом.
Embeddings as a Storage Primitive: могут ли эмбеддинги стать функцией хранилища
В презентации этого прямо нет, но для меня это почти неизбежное продолжение идеи.
Если хранилище уже хранит объект, знает его метаданные, генерирует событие, хранит векторы и обслуживает векторный индекс, то логично спросить: почему конвейер эмбеддингов вообще должен быть внешним?
Можно представить политику: embedding-model = model-X, chunk-size = 1024, vector-index = corporate-docs. Появляется объект. Событие хранилища запускает ускоритель или сервис. Объект разбивается на чанки. Эмбеддинги генерируются. Индекс обновляется. Приложение просто делает PUT. Через некоторое время объект уже доступен для семантического поиска.
Это будет буквально семантическое объектное хранилище.
Таблицы и векторы в одном хранилище: следующий этап AI data platform
Следующий шаг единая плоскость запросов. Сегодня можно сделать SQL-запрос по Iceberg и векторный запрос по векторному индексу. Но корпоративный запрос часто содержит обе части.
Например: «Среди документов финансового департамента за 2026 год найди все, семантически похожее на расследование мошенничества». Структурные фильтры: department = finance, date >= 2026-01-01. Семантический фильтр: similar(query_embedding, document_embedding).
И здесь табличный движок и векторный движок начинают сливаться. Я думаю, что гибридный структурно-семантический запрос станет стандартным паттерном корпоративного AI. И платформы хранения, умеющие эффективно поддерживать оба представления, получат очень сильное преимущество.
От объекта к Knowledge Primitive: как меняется модель данных AI
Это, пожалуй, самый интересный философский вывод.
Сегодня объект это именованный набор байтов. Завтра объект может иметь схему, векторное представление, происхождение, семантические теги, гриф безопасности, связи, версии, производные артефакты, политику хранения и интерфейс запросов.
То есть объект постепенно превращается из примитива хранения в примитив знаний. Это очень большой архитектурный сдвиг.
Почему производные и переиспользуемые данные AI растут быстрее исходных данных
Вернемся к самому началу. Система AI постоянно создает новые представления. Сырой объект один. Но вокруг него появляются несколько версий, несколько чанков, эмбеддинги, индексы, записи таблиц, обучающие копии, чекпоинты, кэшированная предобработка, состояния KV и результаты оценки.
Поэтому планирование емкости будущих систем AI будет определяться не скоростью поступления исходных данных. Куда более важным параметром становится коэффициент умножения представлений: сколько персистентных данных создается из каждого TB исходных?
И это число сильно зависит от сценария. Для простого инференса оно может быть небольшим. Для корпоративного RAG значительно больше. Для мультимодального AI, где сохраняются несколько эмбеддингов и производных представлений, еще больше. Для сред непрерывного обучения огромным.
Вот почему уровень емкости остается критически важным.
Источники и дополнительное чтение
- SNIA, страница вебинара: https://www.snia.org/educational-library/architecting-ai-data-foundations-object-storage-patterns-scale-access-and
- SNIA, презентация (43 слайда): https://www.snia.org/sites/default/files/CSI/Architecting-AI-Data-Foundations.pdf
- SNIA Q&A: Architecting AI Data Foundations: https://www.snia.org/blog/2026/architecting-ai-data-foundations-qa
- Документация Apache Iceberg: https://iceberg.apache.org/
- Документация Amazon S3 Tables: https://docs.aws.amazon.com/AmazonS3/latest/userguide/s3-tables.html
- Amazon S3 Vectors: https://aws.amazon.com/s3/features/vectors/
- Microsoft Research: DiskANN / Project Akupara: https://www.microsoft.com/en-us/research/project/project-akupara-approximate-nearest-neighbor-search-for-large-scale-semantic-search/
- Документация NVIDIA Dynamo: https://docs.nvidia.com/dynamo/
Редакционная оговорка. Текст является авторским техническим разбором и интерпретацией материалов SNIA, а не стенограммой. Численные результаты из вендорских материалов следует читать как результаты конкретных тестовых конфигураций, а не как универсальные гарантии производительности.
Автор: Андрей Гантимуров