Где хранить AI-данные: NVMe, SSD, HDD, SMR и объектное хранилище
Авторы формулируют проблему почти как классический треугольник: данные AI должны одновременно быть быстрыми, дешевыми и переиспользуемыми. Но сделать все данные одновременно сверхбыстрыми и сверхдешевыми невозможно.
Поэтому правильная архитектура начинается не с выбора носителя. Она начинается с классификации нагрузок. И здесь презентация предлагает разделить инфраструктуру как минимум на уровень задержки и уровень емкости.
Hot storage для AI: когда нужны HBM, DRAM и NVMe
Уровень задержки это данные, задержка доступа к которым непосредственно влияет на утилизацию дорогостоящих вычислительных ресурсов.
Сюда попадают загрузка модели, подача данных на обучение, горячий векторный индекс, часть метаданных, чувствительное к задержкам восстановление KV, промежуточное хранение и упреждающее чтение. Здесь имеет смысл использовать DRAM, NVMe SSD, высокопроизводительную файловую систему, NVMe-oF и ускоренный объектный доступ.
Основная метрика здесь не $/TB. Она звучит иначе: «Сколько дорогого времени GPU я теряю из-за СХД?» Если GPU стоимостью десятки тысяч долларов простаивает из-за того, что СХД медленно подает данные, экономия на SSD бессмысленна. Поэтому производительную СХД в AI надо оценивать через утилизацию GPU.
Capacity storage для AI: зачем нужны HDD и объектное хранилище
Но большая часть данных AI не находится постоянно на критичном к задержкам пути.
Сырые датасеты могут читаться периодически. Старые чекпоинты нужны редко. Исторические эмбеддинги могут быть холодными. Корпус RAG огромен, но конкретный запрос затрагивает небольшую его долю. История моделей хранится ради отката. Журналы аудита ради соответствия требованиям. Результаты обучения ради воспроизводимости.
И если все это положить на all-flash, СХД быстро становится одним из крупнейших компонентов TCO. Поэтому для уровня емкости презентация предлагает объектное хранилище на HDD, включая SMR.
Ключевая идея здесь: не каждый байт должен быть быстрым, но каждый байт должен находиться на экономически правильном уровне.
Авторы повторяют этот тезис и в официальном Q&A: чувствительные к задержкам нагрузки имеет смысл размещать на SSD, а емкостные долгоживущие данные AI на HDD, перемещая данные между уровнями политиками жизненного цикла.
Mixed-Fleet Object Storage: единая архитектура AI-хранилища на SSD и HDD
Если бы мне разрешили взять из всей презентации только одну картинку, я бы взял The Mixed-Fleet Object Architecture.
На нем сверху находятся приложения AI: обучение, инференс, RAG, инженерия признаков, наблюдаемость. Ниже расположен единый слой доступа к объектам и данным с S3 API, таблицами, векторами, метаданными, событиями и политиками жизненного цикла. А физически ниже уже два разных класса носителей.
Слева уровень ускорения: NVMe SSD, кэш, упреждающее чтение, высокоскоростное промежуточное хранение. Справа долговременный уровень емкости: объекты на HDD и SMR, датасеты, чекпоинты, корпуса, архив. И еще ниже эксплуатация и доверие: мониторинг, размещение, репликация, шифрование и путь данных, готовый к аттестации.
Финальная фраза на слайде чрезвычайно точная: Object semantics above. Workload-aware placement below. Developers never care where the bytes live.
Для меня это практически манифест современной архитектуры СХД для AI.
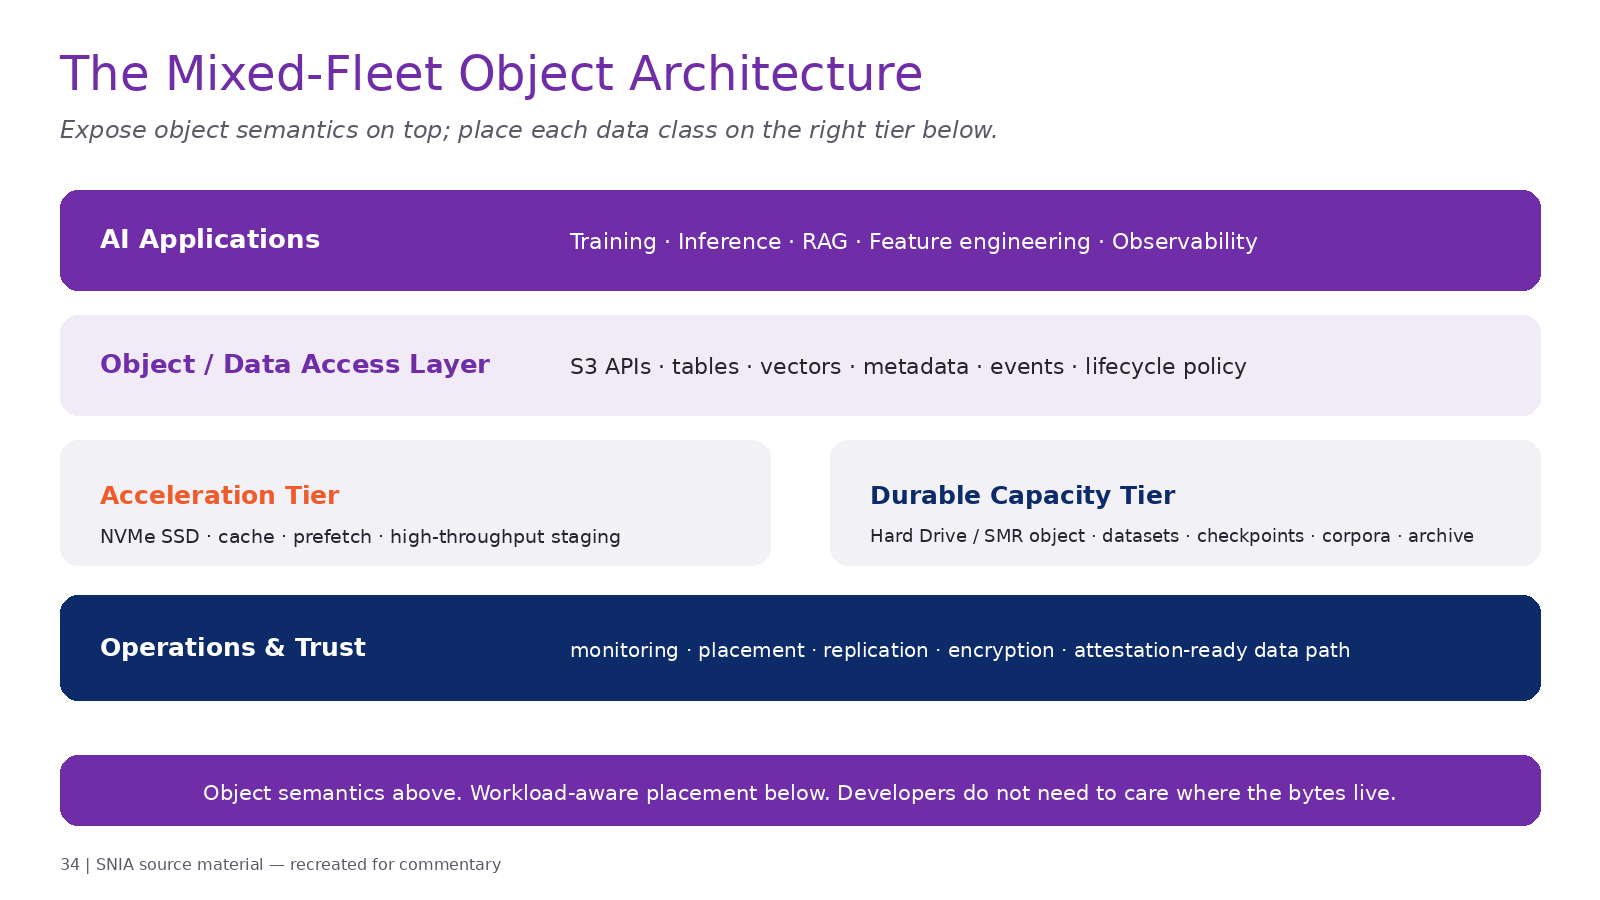
Рисунок 4. Mixed-Fleet Object Architecture: единая объектная семантика над уровнями ускорения и долговременной емкости. По материалам SNIA, слайд 34.
AI-aware tiering: чем интеллектуальное размещение данных отличается от обычного tiering
Многоуровневое хранение существует десятилетиями. Кэш на SSD перед HDD ничего нового. HSM, иерархическое управление хранением, вообще очень старая концепция.
Но здесь появляется важное отличие. В традиционном тиринге мы в основном классифицировали температуру блоков и файлов. В AI-native тиринге мы можем классифицировать семантику представления.
Например: ребра векторного графа → NVMe; полные векторы → емкостные SSD; исходные объекты → HDD; метаданные Iceberg → NVMe; файлы данных Parquet → HDD; текущий чекпоинт → NVMe; старые чекпоинты → HDD; активный KV → HBM; теплый KV → DRAM; переиспользуемый KV → SSD; холодный общий KV → объекты.
Это уже не просто горячие и холодные данные по частоте доступа. Это размещение с учетом приложения.
Именно поэтому метаданные становятся такими важными. СХД должна знать не просто «этот объект читали 17 раз», а желательно: «это чекпоинт модели», «это векторный индекс», «это сырой корпус», «это неизменяемый обучающий датасет», «это переиспользуемое состояние KV». Тогда движок политик может принимать намного более разумные решения.
HDD для AI: зачем искусственному интеллекту емкостные накопители
На первый взгляд странно видеть в 2026 году презентацию про AI, где значительная часть посвящена жестким дискам. AI ассоциируется с HBM, NVLink, NVMe и GPUDirect.
Но если посмотреть на проблему не как на проблему задержки, а как на проблему роста данных, HDD начинают выглядеть вполне логично.
AI производит невероятное количество переиспользуемого состояния: сырые датасеты, подготовленные датасеты, эмбеддинги, чекпоинты, версии моделей, сгенерированные результаты, данные наблюдаемости, истории промптов, данные аудита и архивные корпуса. И значительная часть этих данных нужна не каждую миллисекунду. Поэтому HDD остается крайне эффективным уровнем емкости.
В самой презентации приводится ориентировочная разница примерно в порядок между корпоративными SSD и nearline HDD по $/TB и подчеркивается, что экономика all-flash становится сложной при десятках петабайт персистентного состояния AI. Эти конкретные цифры я бы воспринимал как иллюстрацию, а не универсальную константу: реальные цены сильно зависят от закупок, поколения накопителей, ресурса, сжатия и конфигурации.
Но общий тезис от этого не меняется. Flash нужно использовать там, где flash создает бизнес-ценность, а не просто потому, что нагрузка называется AI.
SMR-диски для AI и объектного хранилища: преимущества и ограничения
Следующий интересный блок Shingled Magnetic Recording. SMR увеличивает плотность записи за счет частичного перекрытия дорожек. Цена ограничение на паттерн записи: в host-managed зонной архитектуре запись в последовательную зону должна идти последовательно.
Для традиционной нагрузки со случайной перезаписью это неудобно. Но для объектного хранилища это зачастую вполне приемлемо. Объектная нагрузка естественным образом тяготеет к записи один раз и многократному чтению, неизменяемым объектам, крупным последовательным записям и версионированию вместо перезаписи. То есть многие ограничения SMR очень хорошо совпадают с объектной семантикой.
Какие AI-нагрузки подходят для SMR-дисков
Посмотрим на чекпоинты. Во время чекпоинтинга состояние модели обычно последовательно сбрасывается в хранилище. Чекпоинт неизменяем. Появился следующий, записывается новый. Старый со временем можно удалить. Это практически идеальная зонная нагрузка.
То же самое с загрузкой данных. Приходит новый объект датасета. Он записывается целиком. Не нужно менять 4 KB где-то в середине старого объекта.
Корпус RAG также часто состоит из неизменяемых или редко изменяемых документов. Холодные артефакты моделей то же самое. Архив очевидный кандидат.
Поэтому SNIA предлагает использовать SMR именно для данных AI, дружественных к дозаписи, и оставлять интенсивно используемые метаданные и индексы на SSD.
На мой взгляд, это важный архитектурный урок. Вместо попытки скрыть ограничения носителя любой ценой лучше сопоставлять нагрузку с носителем, для которого она естественна.
Как объектное хранилище объединяет SSD, HDD и SMR в единую систему
Вот здесь возвращается объектный слой.
Приложение не должно знать: этот конкретный объект находится на NVMe; этот на TLC SSD; этот на QLC; этот на CMR HDD; этот на SMR. Приложение говорит: GET object. А политика хранилища решает размещение.
Именно это позволяет строить действительно разнородную СХД для AI. Сверху одно пространство имен. Снизу разные носители.
Это кажется очевидным, но технически реализовать такую систему хорошо довольно сложно. Нужно прогнозировать миграцию. Не допускать штормов миграции. Сохранять локальность метаданных. Обеспечивать QoS. Понимать, что объект через секунду понадобится GPU. Делать упреждающее чтение. Балансировать емкость. Следить за износом SSD. Выполнять фоновое erasure coding. И все это так, чтобы приложение ничего об этом не знало.
То есть настоящая ценность объектной СХД для AI все больше смещается из физического носителя в интеллект размещения данных.
СХД для AI: почему самое быстрое хранилище не всегда является оптимальным
После разбора всей презентации я бы сформулировал основной принцип следующим образом: AI-ready СХД это не СХД с минимальной задержкой. Это СХД, способная дать правильную задержку правильным данным за правильную цену.
Разница фундаментальная. Если у меня 100 PB данных AI, сделать все 100 PB сверхбыстрыми технически возможно. Экономически чаще всего бессмысленно.
Мне нужно определить рабочий набор. Предсказать переиспользование. Держать горячее состояние близко к вычислениям. Автоматически отодвигать холодное. Но при необходимости быстро возвращать его обратно.
По сути задача становится очень похожа на проектирование иерархии кэшей в CPU. Только масштаб теперь измеряется от HBM до эксабайт.
All-flash storage для AI: где SSD остаются необходимыми
Еще одна важная оговорка. То, что SNIA активно защищает гибридную архитектуру HDD+SSD, не означает, что all-flash неправильный.
Есть нагрузки, где all-flash абсолютно оправдан: небольшой, но крайне чувствительный к задержкам датасет; высокоценный инференс в реальном времени; постоянно используемый векторный корпус; крупный кластер обучения, где стоимость простоя GPU огромна; среды, где плотность в стойке важнее цены носителя.
Иными словами, выбор носителя должен быть экономической оптимизацией, а не религией. Именно это, пожалуй, центральная мысль второй половины презентации.
TCO AI-хранилища: почему $/TB недостаточно для оценки инфраструктуры
Это вообще отдельная тема. Традиционные закупки СХД любят метрики $/TB, $/IOPS, GB/s на узел. Для AI этого недостаточно.
Я бы смотрел на стоимость одного прогона обучения, утилизацию GPU, время до первого токена, токены в секунду на GPU, число параллельных сессий на GPU, стоимость миллиона токенов, накладные расходы на чекпоинты, время восстановления, задержку запросов RAG и стоимость хранения одной версии модели.
И тогда иногда дорогая СХД оказывается дешевле. Например, если $1 млн дополнительных NVMe увеличивает утилизацию кластера GPU стоимостью $50 млн на 10%, СХД практически бесплатна.
А иногда наоборот. Покупать 50 PB flash для архивных данных только ради того, чтобы они теоретически могли читаться быстрее, может быть экономически абсурдно.
Оптимизация хранения AI: как размещать данные по стоимости и ценности
В Q&A SNIA очень хорошо формулирует этот подход: не нужно оптимизировать каждый байт под максимальную скорость, нужно оптимизировать его под ценность.
Я бы сделал эту фразу практически принципом проектирования. Жизненный цикл данных AI невероятно длинный. Сегодня объект участвует в обучении. Завтра он холодный. Через месяц используется для оценки. Через год нужен для аудита. Через два года для переобучения новой модели.
Если архитектура умеет динамически менять его размещение без изменения семантики для приложения, мы получаем огромную экономию.
Источники и дополнительное чтение
- SNIA, страница вебинара: https://www.snia.org/educational-library/architecting-ai-data-foundations-object-storage-patterns-scale-access-and
- SNIA, презентация (43 слайда): https://www.snia.org/sites/default/files/CSI/Architecting-AI-Data-Foundations.pdf
- SNIA Q&A: Architecting AI Data Foundations: https://www.snia.org/blog/2026/architecting-ai-data-foundations-qa
- Документация Apache Iceberg: https://iceberg.apache.org/
- Документация Amazon S3 Tables: https://docs.aws.amazon.com/AmazonS3/latest/userguide/s3-tables.html
- Amazon S3 Vectors: https://aws.amazon.com/s3/features/vectors/
- Microsoft Research: DiskANN / Project Akupara: https://www.microsoft.com/en-us/research/project/project-akupara-approximate-nearest-neighbor-search-for-large-scale-semantic-search/
- Документация NVIDIA Dynamo: https://docs.nvidia.com/dynamo/
Редакционная оговорка. Текст является авторским техническим разбором и интерпретацией материалов SNIA, а не стенограммой. Численные результаты из вендорских материалов следует читать как результаты конкретных тестовых конфигураций, а не как универсальные гарантии производительности.
Автор: Андрей Гантимуров